

기업의 중요 시스템은 서버 한 대에 장애가 발생했다고 전체 서비스가 중단되지 않도록 이중화 구조를 적용하는 경우가 많다.
이때 자주 사용되는 방식이 Active-Active와 Active-Standby다.
두 방식 모두 서버나 서비스 장애에 대비한다는 목적은 같지만 정상 운영 중에 서버를 사용하는 방식과 장애 발생 시 처리 과정에는 차이가 있다.
Active-Active → 여러 서버가 동시에 서비스
Active-Standby → 주 서버가 서비스하고 대기 서버가 장애 시 승계
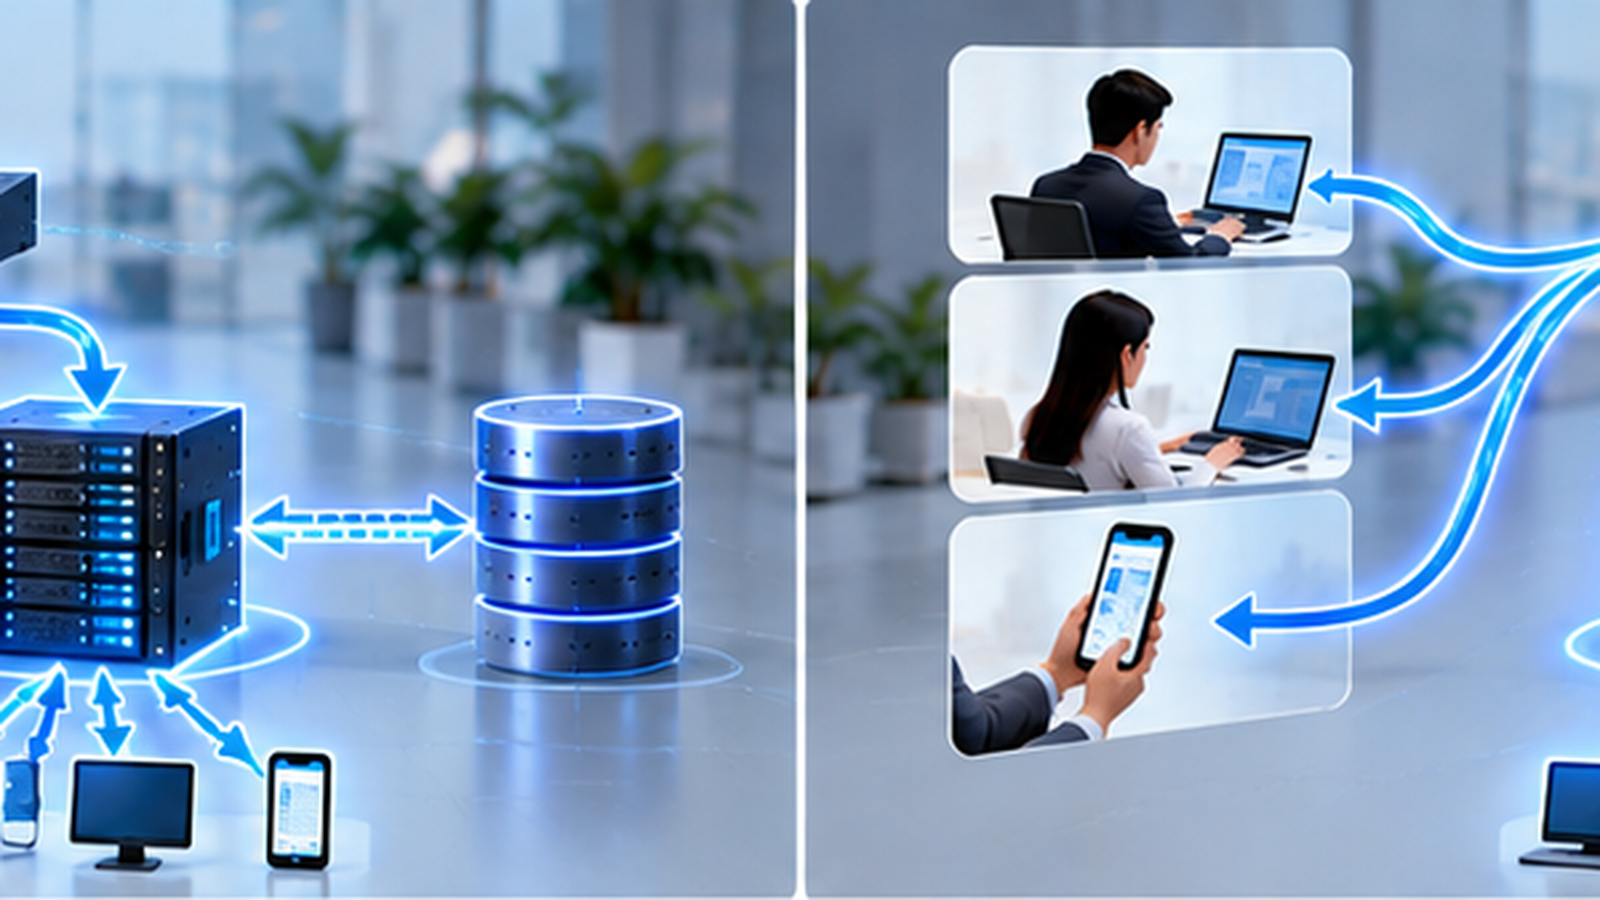
그러나 실제 시스템 설계에서는 어느 방식이 무조건 더 우수하다고 말하기 어렵다.
애플리케이션의 구조, 데이터 저장 방식, 세션 처리, 장애 시 필요한 복구 시간, 비용과 운영 복잡도를 함께 고려해야 한다.
Active-Active에서는 여러 노드가 동시에 서비스를 처리한다
Active-Active 구성에서는 두 대 이상의 서버가 모두 활성 상태로 실제 요청을 처리한다.
사용자 → 로드밸런서 → 서버 A / 서버 B
서버 A와 서버 B가 정상적으로 운영되는 동안 사용자 요청을 나누어 처리한다.
이 구조의 중요한 특징은 정상 상황에서도 모든 노드의 자원을 사용할 수 있다는 것이다.
Active-Active의 장점은 자원 활용과 확장성이다
Active-Active의 대표적인 장점은 정상 운영 중 여러 노드를 사용할 수 있다는 것이다.
사용량이 증가하면 추가 서버를 구성해 부하를 분산하는 구조로 확장할 수도 있다.
- 트래픽이 많은 웹서비스
- 여러 서버로 요청을 분산할 수 있는 서비스
- 수평 확장이 필요한 시스템
- 일부 노드 장애에도 서비스를 지속해야 하는 시스템
다만 서버가 두 대라고 처리 성능이 정확히 두 배가 되는 것은 아니다. 로드밸런싱, 네트워크, 데이터베이스, 공유 자원 등이 병목이 될 수 있다.
Active-Active에서는 장애가 발생하면 남은 노드가 부하를 처리한다
서버 A와 서버 B가 서비스를 처리하다 서버 A에 장애가 발생하면 남은 서버 B가 더 많은 요청을 처리해야 한다.
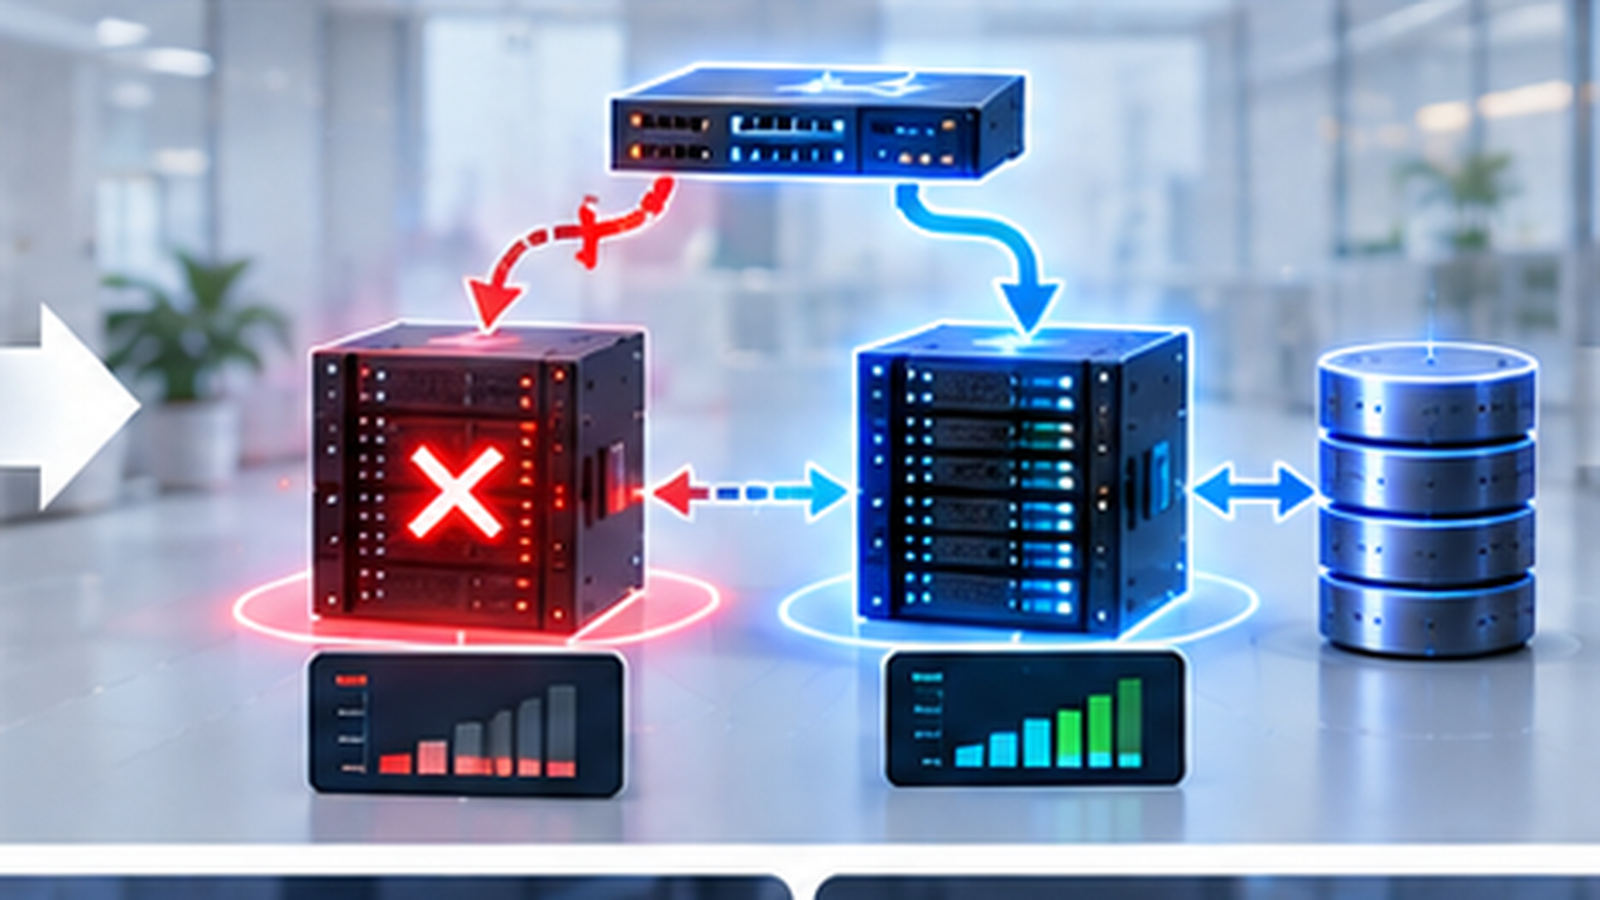
정상 상태 → 서버 A + 서버 B
장애 상태 → 서버 B
따라서 Active-Active에서는 정상 상태의 CPU 사용률만 보고 용량을 설계해서는 안 된다.
하나의 노드가 없어졌을 때도 남은 자원으로 필요한 서비스 수준을 유지할 수 있는지를 확인해야 한다.
Active-Standby에서는 한 서버가 서비스하고 다른 서버는 대기한다
Active-Standby는 Active-Passive라고도 부른다.
정상 상황에서는 Active 서버가 서비스를 처리하고 Standby 서버는 실제 서비스 처리를 하지 않거나 제한적인 역할만 수행한다.
정상 상태 → Active 서버 서비스 / Standby 서버 대기
Active 서버에 장애가 발생하면 대기 서버가 서비스를 넘겨받는다.
Active 서버 장애 → Failover → Standby 서버가 새로운 Active
Active-Standby의 장점은 구조가 상대적으로 단순하다는 점이다
Active-Standby에서는 정상적으로 서비스를 처리하는 주체가 명확하다.
특히 동시에 여러 서버에서 실행하기 어려운 애플리케이션이나 하나의 Active 인스턴스만 허용하는 시스템에서 적용하기 쉽다.
- 단일 Active 인스턴스를 전제로 하는 애플리케이션
- 여러 노드의 동시 실행이 어려운 시스템
- 구조 단순성과 예측 가능성이 중요한 환경
- 장애 발생 시 일정 수준의 전환 시간을 허용할 수 있는 시스템
대기 서버의 자원이 정상 운영 중 충분히 활용되지 않을 수 있다는 점은 고려해야 한다.
Standby도 준비 상태에 따라 차이가 있다
Hot Standby
대기 서버가 실행 중이고 필요한 데이터와 상태가 지속적으로 동기화되어 장애 시 빠르게 서비스를 넘겨받을 수 있는 구조다.
Warm Standby
대기 시스템이 일정 부분 준비되어 있지만 서비스 전환을 위해 추가 절차가 필요한 구조다.
Cold Standby
대기 환경은 준비되어 있지만 장애 이후 시스템 시작, 데이터 복구, 서비스 설정 등의 작업이 필요한 구조다.
따라서 단순히 Active-Standby라는 이름만으로 실제 복구시간을 판단해서는 안 된다.
Active-Active는 로드밸런서와 함께 사용하는 경우가 많다
여러 서버가 동시에 요청을 처리하려면 사용자의 요청을 어느 서버로 전달할지 결정해야 한다.
사용자 → Load Balancer → Server A / Server B
로드밸런서는 요청을 분산하고 Health Check를 이용해 장애가 발생한 서버로 새로운 요청을 보내지 않도록 구성할 수 있다.
따라서 Active-Active의 고가용성은 서버 두 대만 구성한다고 자동으로 만들어지는 것이 아니다.
세션을 서버에 저장하면 Active-Active가 복잡해질 수 있다
웹 애플리케이션에서는 로그인 상태나 장바구니처럼 사용자의 상태정보를 유지해야 하는 경우가 있다.
세션이 서버 A에만 저장되어 있는데 다음 요청이 서버 B로 전달되면 사용자 상태를 찾지 못할 수 있다.
이를 해결하는 방법에는 다음과 같은 방식이 있다.
- Sticky Session
- 외부 세션 저장소
- 노드 간 세션 복제
- Stateless 애플리케이션 설계
따라서 Active-Active 적용 가능성을 판단할 때 애플리케이션이 Stateful인지 Stateless인지 확인하는 것이 중요하다.
데이터베이스는 애플리케이션 서버보다 Active-Active 구성이 복잡할 수 있다
여러 데이터베이스 노드가 동시에 같은 데이터를 수정하는 환경에서는 동시 쓰기 충돌과 데이터 정합성을 고려해야 한다.
- 동시 쓰기 충돌
- 데이터 복제 지연
- 트랜잭션 정합성
- 장애 후 데이터 병합
- 최신 데이터 판단
따라서 다음과 같은 조합도 가능하다.
웹 서버 → Active-Active
데이터베이스 → Active-Standby
Active-Standby에서는 Failover가 핵심이다
Active-Standby 구성에서는 Active 서버 장애를 얼마나 빠르게 탐지하고 Standby 서버로 서비스를 넘기는지가 중요하다.
Active 서버 정상 운영 → Health Check 또는 Heartbeat 이상 감지 → 장애 판단 → Standby 활성화 → 서비스 역할 이전 → 서비스 재개
따라서 Active-Standby의 가용성은 단순히 대기 서버가 존재하는지가 아니라 Failover가 얼마나 빠르고 안정적으로 수행되는지에 따라 달라진다.
장애 감지를 너무 민감하게 설정하는 것도 문제가 될 수 있다
Heartbeat나 Health Check가 잠시 실패했다고 바로 Failover를 실행하면 일시적인 네트워크 지연에도 서버 역할이 변경될 수 있다.
- Health Check 주기
- 실패 허용 횟수
- 장애 판정 시간
- Failover 조건
- 애플리케이션 시작 시간
장애 감지 정책은 시스템 특성에 따라 적절하게 설계해야 한다.
Failback도 함께 설계해야 한다
Failover 이후 기존 Active 서버가 복구되었다고 즉시 원래 서버로 서비스를 되돌릴 필요는 없다.
기존 Active 장애 → Standby로 Failover → 장애 서버 복구 → 데이터·상태 확인 → Failback 판단 → 원래 구조 복귀
Failover와 함께 Failback 정책도 설계해야 한다.
Split-Brain은 이중화 환경에서 반드시 고려해야 한다
두 노드 사이의 통신이 끊어지면 양쪽 서버가 상대방을 장애로 판단하고 모두 자신이 Active라고 판단할 수 있다.
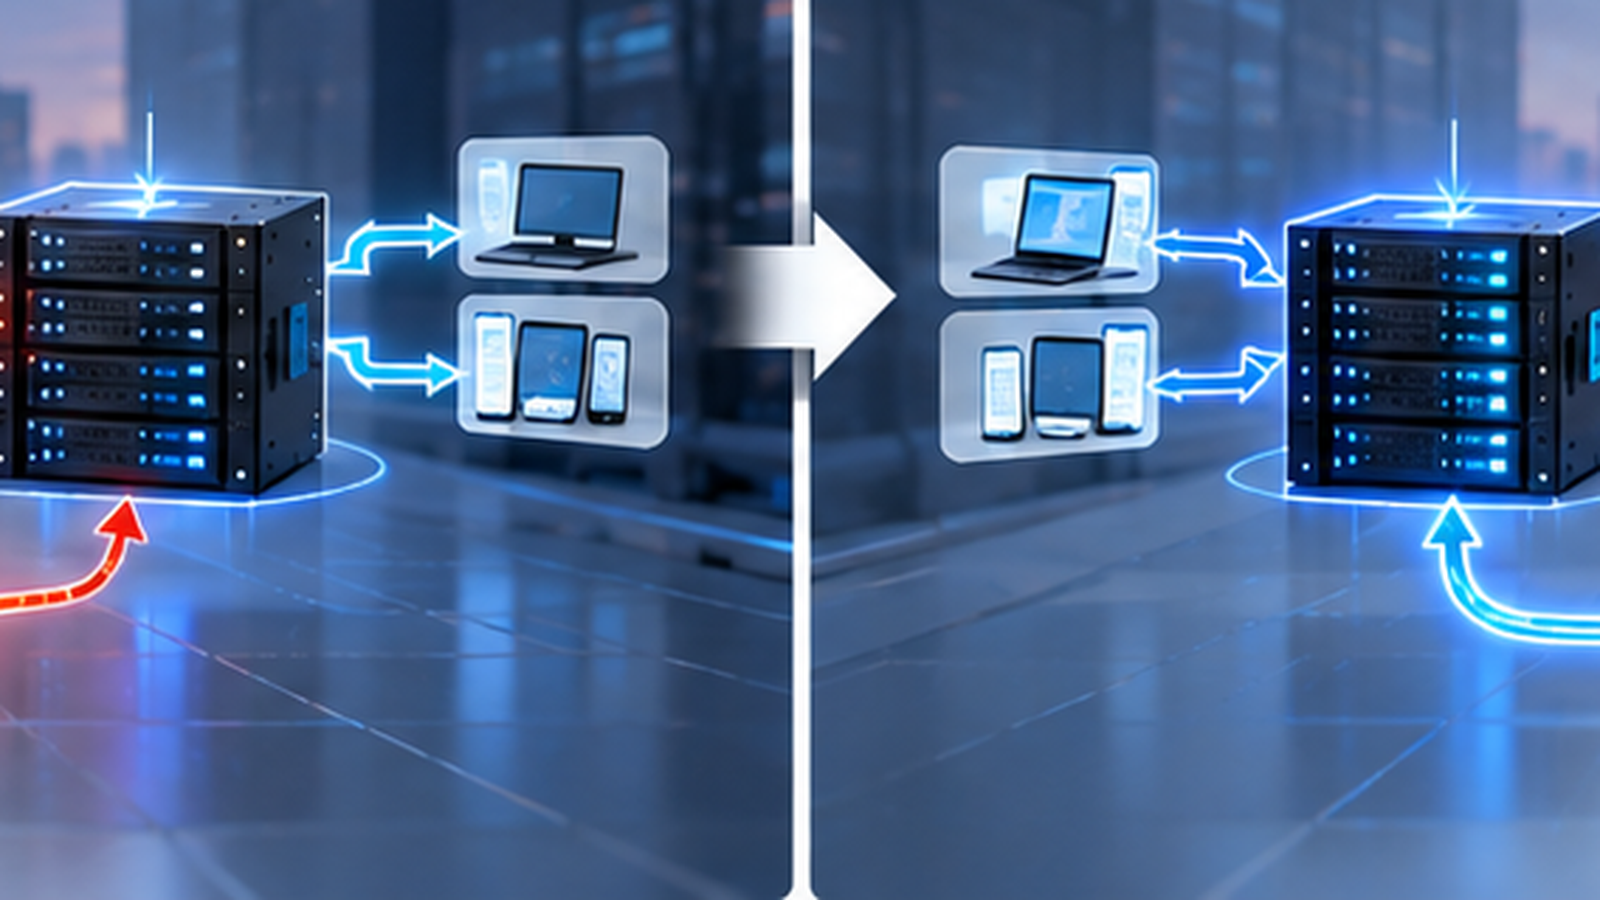
이를 Split-Brain이라고 한다.
특히 공유 데이터에 두 노드가 동시에 쓰기를 수행하면 데이터 정합성 문제가 발생할 수 있다.
이를 방지하기 위해 클러스터에서는 Quorum이나 Witness 구조를 사용할 수 있다.
중요한 것은 어느 노드가 서비스를 소유할 권한이 있는지를 명확하게 결정하는 구조다.
Active-Active와 Active-Standby의 차이를 비교하면 구조가 명확해진다
| 구분 | Active-Active | Active-Standby |
|---|---|---|
| 정상 상태 | 여러 노드가 서비스 | Active 노드가 서비스 |
| 대기 노드 | 별도 대기 없음 또는 최소화 | Standby 노드 존재 |
| 자원 활용 | 높은 편 | 낮을 수 있음 |
| 부하 분산 | 가능 | 일반적으로 목적이 아님 |
| 장애 시 | 남은 노드가 요청 처리 | Standby가 역할 승계 |
| 구조 복잡성 | 상대적으로 높음 | 상대적으로 단순 |
| 상태 관리 | 중요 | 상대적으로 단순할 수 있음 |
| 주요 고려사항 | 용량·세션·동기화 | Failover 시간·대기 상태 |
| 적합한 환경 | 분산 가능한 서비스 | 단일 Active가 적합한 서비스 |
Active-Active가 항상 더 높은 가용성을 의미하지는 않는다
Active-Active는 자원 활용과 확장 측면에서 장점이 있지만 구조가 복잡해지면서 새로운 장애 지점이 생길 수 있다.
- 로드밸런서 장애
- 세션 동기화 실패
- 데이터 복제 오류
- 노드 사이 상태 불일치
- 장애 서버 제거 실패
- 남은 서버의 용량 부족
따라서 Active-Active를 단순히 더 높은 단계의 기술이라고 판단할 필요는 없다.
RTO와 RPO를 기준으로 구조를 결정할 수 있다
RTO
Recovery Time Objective는 장애가 발생한 뒤 서비스를 복구해야 하는 목표 시간이다.
RPO
Recovery Point Objective는 장애 이후 허용할 수 있는 데이터 손실 범위를 시간 기준으로 표현한다.
RTO가 매우 짧다면 자동 Failover 구조가 중요해질 수 있고, RPO가 매우 짧다면 데이터 동기화 방식이 중요해진다.
구조 선택은 기술 취향이 아니라 업무 요구사항에서 출발해야 한다.
장애 도메인을 확인하지 않으면 서버 이중화 효과가 제한될 수 있다
두 서버가 같은 전원, 같은 스위치, 같은 스토리지를 공유한다면 공통 장애가 발생할 수 있다.
- 전원
- 네트워크 스위치
- 스토리지
- 로드밸런서
- 랙
- 데이터센터
- 인터넷 회선
고가용성 설계는 서버 두 대를 놓는 작업이 아니라 동일 장애가 여러 노드를 동시에 중단시킬 수 있는 지점을 제거하는 과정이다.
트래픽이 많다고 무조건 Active-Active가 필요한 것은 아니다
다음과 같은 질문을 먼저 확인하는 것이 좋다.
여러 서버가 동시에 같은 서비스를 처리할 수 있는가.
사용자 세션은 어디에 저장되는가.
데이터를 여러 서버에서 동시에 수정하는가.
한 서버가 장애 나도 나머지 서버가 전체 부하를 감당할 수 있는가.
허용 가능한 서비스 중단 시간은 얼마인가.
데이터 손실 허용 범위는 어느 정도인가.
운영 조직이 복잡한 클러스터 구조를 관리할 수 있는가.
애플리케이션 계층별로 다른 방식을 사용할 수 있다
실제 기업 시스템은 하나의 Active-Active 또는 Active-Standby 구조로만 구성되지 않을 수 있다.
Load Balancer → Active-Active
Web Server → Active-Active
Application Server → Active-Active
Database → Active-Standby
Storage → Controller Redundancy
각 계층별 장애 특성과 운영 요구사항을 기준으로 적합한 구조를 적용하는 것이 중요하다.
가장 중요한 단계는 실제 장애 테스트다
설계 문서에 이중화라고 표시되어 있다고 실제 장애 상황에서 정상적으로 전환된다는 보장은 없다.
- Active 서버 강제 종료
- 애플리케이션 프로세스 중단
- 네트워크 연결 단절
- 로드밸런서 Health Check 실패
- 스토리지 연결 장애
- Heartbeat 통신 장애
- Failover 이후 서비스 확인
- 장애 서버 복구 후 Failback
테스트에서는 서버 역할 전환뿐 아니라 사용자가 실제 서비스를 이용할 수 있는지도 확인해야 한다.
Active-Active와 Active-Standby 선택은 업무 요구사항에서 시작한다
Active-Active는 여러 노드가 동시에 서비스를 처리해 자원 활용과 확장 측면에서 장점이 있다.
Active-Standby는 하나의 Active 노드를 중심으로 운영해 구조와 장애 전환 과정을 상대적으로 단순하게 설계할 수 있다.
다음 기준을 함께 확인해야 한다.
- 서비스 중단 허용시간
- 데이터 손실 허용범위
- 애플리케이션의 Stateful·Stateless 구조
- 데이터 동기화 방식
- 장애 시 필요한 처리 용량
- Failover 자동화 수준
- 구축·운영 비용
- 운영 인력의 관리 역량
결국 중요한 것은 Active-Active라는 이름을 사용하는 것이 아니다.
장애가 발생했을 때 실제 서비스가 요구된 수준으로 계속 동작할 수 있는 구조를 만드는 것이 고가용성 설계의 목적이다.