

기업의 서버 장애 대응 방안을 이야기할 때 자주 함께 등장하는 용어가 이중화와 백업이다. 두 기술 모두 장애에 대비하기 위한 수단이지만 목적은 다르다.
이중화는 서버나 네트워크, 스토리지 같은 구성 요소에 문제가 발생했을 때 다른 구성 요소가 서비스를 이어받도록 해 서비스 중단 시간을 줄이는 것이 핵심이다. 반면 백업은 데이터가 삭제되거나 손상되었을 때 과거 시점의 데이터를 이용해 정상 상태로 복구하는 것이 핵심이다.
Microsoft의 신뢰성 설계 가이드에서도 중복 구성은 단일 장애 지점을 제거하고 장애 발생 시 다른 리소스로 전환할 수 있도록 하는 방식으로 설명한다. 반면 AWS는 백업을 RTO와 RPO 요구사항에 맞춰 데이터·애플리케이션·구성을 복구하기 위한 수단으로 구분한다. 따라서 서버를 이중화했다고 해서 백업이 필요 없어지는 것도 아니고, 백업을 구축했다고 해서 서비스 가용성이 확보되는 것도 아니다.
1. 이중화와 백업의 핵심 차이
이중화와 백업을 가장 간단하게 구분하면 이중화는 서비스를 계속 운영하기 위한 구조이고, 백업은 데이터를 다시 복구하기 위한 구조라고 볼 수 있다.
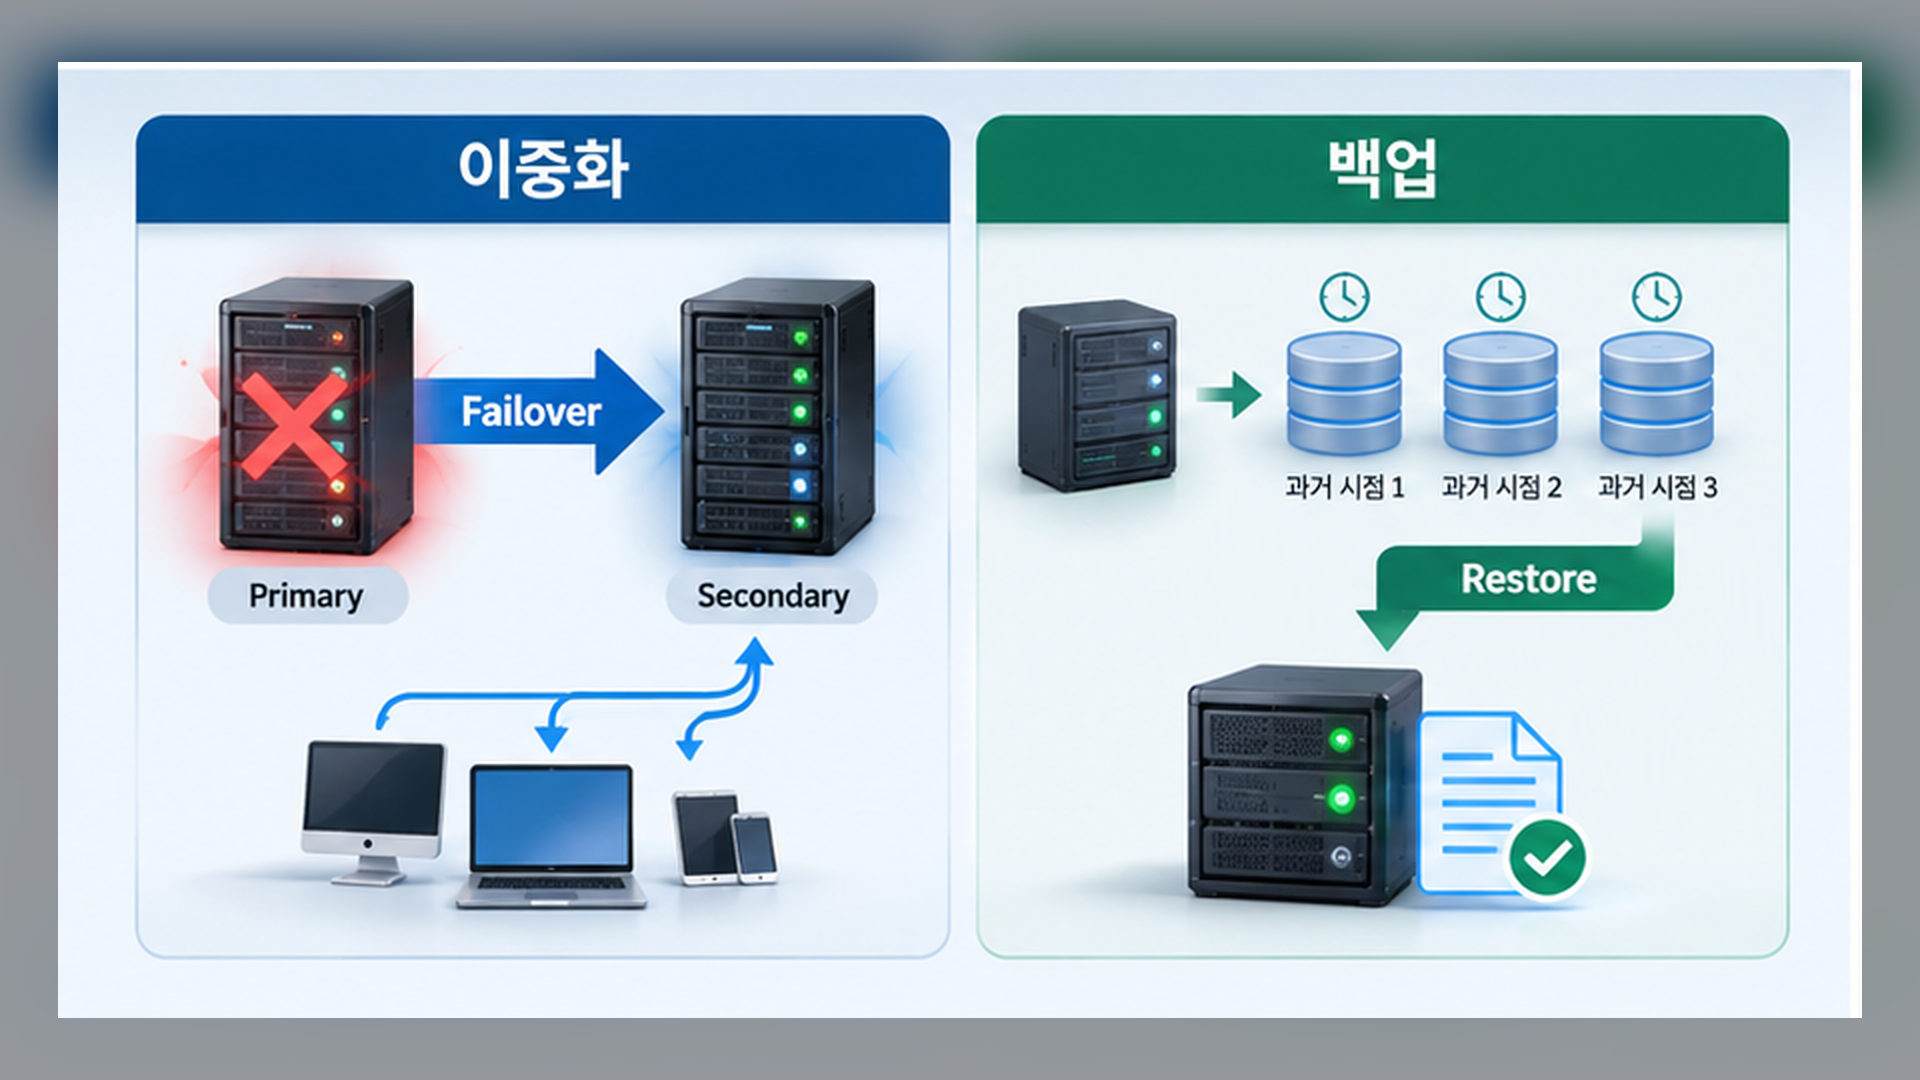
| 구분 | 이중화 | 백업 |
|---|---|---|
| 주요 목적 | 서비스 가용성 유지 | 데이터 및 시스템 복구 |
| 주요 대응 상황 | 서버·네트워크·스토리지 등 구성 요소 장애 | 삭제·손상·오류·재해 등 |
| 대표 동작 | Failover | Restore |
| 데이터 상태 | 운영 데이터와 지속적으로 동기화되는 경우가 많음 | 특정 시점의 데이터 복사본 보존 |
| 장애 발생 후 목표 | 다른 시스템으로 빠르게 서비스 전환 | 정상 데이터를 찾아 복구 |
| RTO와의 관계 | 중단 시간을 줄이는 데 효과적 | 복원 절차에 따라 시간이 필요 |
| RPO와의 관계 | 복제 방식에 따라 매우 짧게 구성 가능 | 백업 주기에 따라 데이터 손실 범위 결정 |
Microsoft는 Active-Active를 여러 인스턴스가 동시에 요청을 처리하는 구조로, Active-Passive를 주 시스템에 문제가 발생하면 보조 시스템이 서비스를 담당하는 구조로 설명한다. 이런 구조의 핵심은 문제가 발생해도 서비스가 다른 리소스로 계속 제공될 수 있도록 만드는 데 있다.
반대로 백업은 서비스를 즉시 대신 처리하는 서버가 아니다. 장애 전 데이터를 보관해 두었다가 필요할 때 해당 데이터를 다시 가져오는 복구 수단에 가깝다.
2. 서버 이중화가 장애를 처리하는 방식
서버 이중화에서는 동일하거나 유사한 역할을 수행할 수 있는 자원을 둘 이상 준비한다. 예를 들어 웹 서비스를 운영하는 서버가 두 대 있다고 가정해 보자. 한 서버에 장애가 발생하더라도 다른 서버가 요청을 계속 처리할 수 있다면 사용자는 장애를 느끼지 못하거나 짧은 서비스 지연만 경험할 수 있다.
이러한 구조에서는 서버 자체만 이중화해서는 충분하지 않은 경우가 많다. 네트워크, 로드밸런서, 데이터베이스, 스토리지 등 서비스 경로에 존재하는 다른 구성 요소에도 단일 장애 지점이 남아 있다면 전체 서비스는 여전히 중단될 수 있다. Microsoft 역시 신뢰성이 중요한 시스템에서는 컴퓨팅뿐 아니라 네트워크와 스토리지 등 여러 계층에 중복 구성을 적용하고, 필요하면 자동 Failover를 사용하도록 권고한다.
즉, 이중화의 핵심은 장애가 발생하지 않게 만드는 것이 아니라 장애가 발생해도 서비스를 지속할 수 있도록 설계하는 것이다.
3. 백업이 필요한 이유
백업은 운영 시스템과 별도로 데이터나 시스템 상태를 보존한다. 대표적인 예가 데이터베이스를 매일 특정 시각에 백업하거나 일정 주기로 증분 백업을 수행하는 방식이다. 장애가 발생하면 정상 상태라고 판단되는 백업 데이터를 선택해 시스템을 복구한다.
백업에서는 데이터를 저장하는 것만큼 실제로 복원할 수 있는지 검증하는 과정이 중요하다. AWS Well-Architected Framework에서도 데이터·애플리케이션·구성의 자동 백업뿐 아니라 주기적인 복구 작업을 통해 백업 무결성과 복구 프로세스를 확인하도록 권고한다.
백업의 진짜 목적은 '백업 작업 성공'이 아니다. 필요한 시점의 데이터를 요구된 시간 안에 복구할 수 있는 상태를 만드는 것이 목적이다.
4. 장애 유형에 따라 달라지는 대응 방식
이중화와 백업이 필요한 이유는 두 기술이 해결하는 장애 유형이 다르기 때문이다.
| 장애 상황 | 이중화 | 백업 |
|---|---|---|
| 서버 하드웨어 장애 | 효과적 | 복구 가능하지만 시간이 필요 |
| 서버 OS 장애 | 구성에 따라 Failover 가능 | 시스템 복원이 필요할 수 있음 |
| 네트워크 장비 장애 | 네트워크 이중화 구성 시 대응 가능 | 직접적인 대응 수단이 아님 |
| 데이터베이스 서버 장애 | HA 구성 시 대응 가능 | DB 복원 가능 |
| 파일 실수 삭제 | 삭제가 동기화되면 보호하기 어려움 | 과거 백업으로 복구 가능 |
| 데이터 논리적 손상 | 손상이 복제될 수 있음 | 정상 시점 백업으로 복구 가능 |
| 잘못된 애플리케이션 변경 | 동일 문제가 이중화 서버에 존재할 수 있음 | 이전 상태 복구에 활용 가능 |
| 데이터센터·지역 장애 | 별도 사이트·지역 이중화가 필요 | 원격 백업이 있으면 복구 가능 |
Google Cloud의 재해복구 가이드도 재해복구 범위를 단순한 인프라 장애에 한정하지 않고 소프트웨어 오류나 데이터 손상까지 고려해야 한다고 설명한다. 이 차이를 이해하지 못하면 “서버가 두 대 있으니 안전하다”거나 “매일 백업하니 장애 대응이 충분하다”는 잘못된 판단이 발생하기 쉽다.
5. RTO와 RPO로 보는 이중화와 백업
장애 대응 구조를 설계할 때 중요한 기준이 RTO(Recovery Time Objective)와 RPO(Recovery Point Objective)다. NIST는 RTO를 정보 시스템 구성 요소가 조직의 업무에 영향을 주기 전에 복구 단계에 머물 수 있는 시간과 관련된 목표로 정의하고, RPO는 장애 이후 데이터를 어느 시점까지 복구해야 하는지를 나타내는 개념으로 정의한다.
쉽게 표현하면 RTO는 “얼마나 빨리 다시 서비스를 시작해야 하는가”이고, RPO는 “얼마나 이전 시점까지의 데이터 손실을 허용할 수 있는가”다.
예를 들어 업무 시스템의 RTO가 10분이라면 장애 이후 10분 안에 서비스를 복구할 수 있는 구조가 필요하다. 단순히 하루에 한 번 백업하는 방식만으로는 시스템 전체를 복원하는 시간이 길어질 수 있기 때문에 이중화나 대기 시스템이 필요할 가능성이 높다. 반대로 RPO가 24시간이라면 하루 단위 백업이 기술적으로 요구사항을 충족할 수 있지만, RPO가 5분이라면 훨씬 짧은 백업 주기나 데이터 복제 기술을 검토해야 한다.
Google Cloud 역시 시스템의 중요도에 따라 RTO와 RPO를 먼저 결정하고 이를 기반으로 다중 영역·다중 지역 구성이나 백업·복구 방식을 선택하는 접근을 설명한다.
6. 이중화만으로 데이터를 보호하기 어려운 이유
이중화 시스템에서 특히 주의해야 할 부분은 복제와 백업을 동일하게 생각하는 것이다. 데이터베이스나 스토리지를 실시간 또는 준실시간으로 복제하면 주 시스템에 장애가 발생했을 때 보조 시스템으로 빠르게 전환할 수 있다. 가용성 측면에서는 매우 효과적이다.
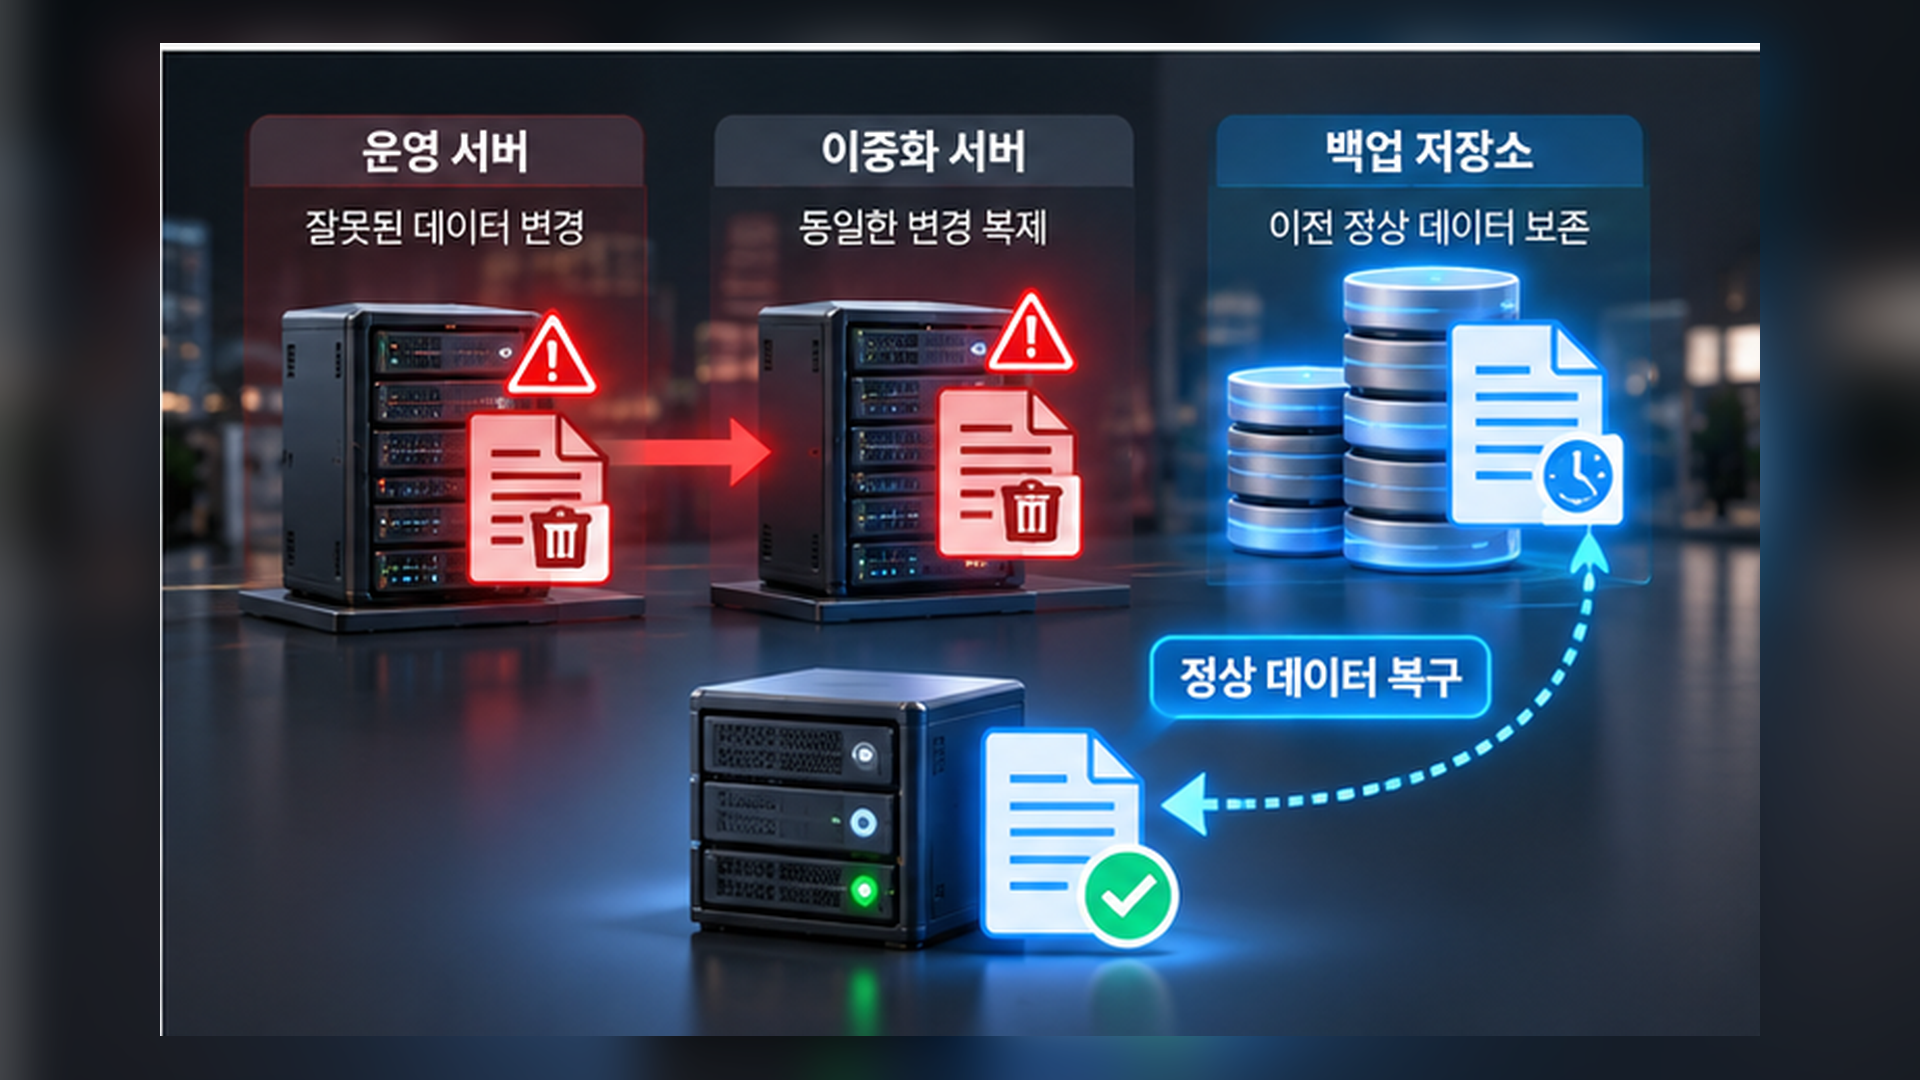
하지만 운영 데이터에서 발생한 논리적 오류까지 그대로 복제될 수 있다는 문제가 있다. 예를 들어 관리자가 중요한 데이터를 실수로 삭제했고 삭제 작업이 정상적인 데이터 변경으로 처리되었다면 해당 변경 사항이 보조 시스템에도 동기화될 수 있다. 애플리케이션 오류가 잘못된 데이터를 대량으로 기록하는 경우에도 같은 문제가 발생할 수 있다.
이때 필요한 것이 특정 시점으로 돌아갈 수 있는 백업이나 Point-in-Time Recovery 같은 별도의 복구 체계다. 실제 Google Cloud의 데이터베이스 관련 가이드에서도 고가용성을 위한 복제와 별도로 논리적 데이터 손상이나 잘못된 삭제 등에 대응하기 위한 백업 및 시점 복구 기능을 구분한다.
따라서 복제된 데이터가 여러 개 존재한다는 사실과 복구 가능한 백업 데이터가 존재한다는 사실은 같은 의미가 아니다.
7. 기업 환경에서 이중화와 백업을 함께 설계하는 방법
기업 시스템에서는 이중화와 백업 중 하나를 선택하기보다 업무 중요도와 장애 영향에 따라 두 기술을 조합하는 것이 일반적이다. 예를 들어 중요한 고객 서비스라면 서버와 데이터베이스를 이중화해 일반적인 장비 장애에서는 서비스를 계속 제공하도록 하고, 별도의 백업 데이터를 유지해 논리적 데이터 손상이나 대규모 장애에도 복구할 수 있도록 설계할 수 있다.
지역 단위 장애까지 고려해야 한다면 구성 범위는 더 넓어진다. Microsoft는 Availability Zone이나 다중 지역 구성으로 가용성을 높이면서 별도의 지역에 백업을 보관하는 방식을 함께 사용할 수 있다고 설명한다. 이 경우 이중화는 서비스 연속성을 담당하고 백업은 더 넓은 장애 범위에 대한 복구 계층을 추가한다.
중요한 것은 모든 시스템을 최고 수준으로 이중화하는 것이 아니다. 시스템의 업무 영향도, 허용 가능한 중단 시간, 데이터 손실 허용 범위와 비용을 기준으로 적절한 수준을 결정해야 한다.
8. 실무자 관점에서 확인해야 할 사항
현장에서 장애 대응 체계를 확인할 때 “서버가 이중화되어 있는가”, “백업을 하고 있는가”라는 질문만으로는 충분하지 않다. 실제로는 장애 범위, Failover 방식과 시간, RTO·RPO, 백업 분리 여부, 복원 검증, 운영 절차까지 확인해야 한다.
| 확인 영역 | 실무 확인 내용 |
|---|---|
| 장애 범위 | 서버 한 대 장애뿐 아니라 스토리지·네트워크·사이트 장애까지 어디까지 대응하는가 |
| Failover | 장애 발생 시 자동 전환인지 수동 전환인지, 실제 전환 시간이 얼마인지 |
| RTO | 업무가 허용할 수 있는 최대 중단 시간과 실제 복구 시간이 일치하는지 |
| RPO | 허용 가능한 데이터 손실 시간과 백업·복제 주기가 일치하는지 |
| 백업 분리 | 운영 환경 문제의 영향을 백업도 함께 받을 가능성이 있는지 |
| 복원 검증 | 백업 파일 존재 여부가 아니라 실제 Restore 테스트를 수행했는지 |
| 운영 절차 | 담당자, 장애 판단 기준, Failover·Restore·Failback 절차가 문서화되어 있는지 |
특히 백업 성공 로그와 복구 가능성은 동일하지 않다. 백업 작업이 매일 성공했다고 표시되어 있어도 실제 복원 절차가 검증되지 않았다면 장애 상황에서 예상보다 훨씬 긴 시간이 필요할 수 있다. Microsoft의 DR 가이드 역시 복구 계획을 정기적으로 연습하고 실제 Failover와 데이터 무결성을 검증하는 것을 강조한다.
실무에서는 기술 도입 여부보다 장애 상황에서 누가, 무엇을, 어떤 순서로, 어느 시간 안에 복구할 수 있는지까지 확인해야 한다.
결론
서버 이중화와 백업은 모두 장애 대응을 위한 기술이지만 역할은 명확하게 다르다. 이중화는 서버나 네트워크 등의 장애가 발생했을 때 다른 시스템으로 서비스를 전환해 가용성을 유지하는 기술이다. 백업은 데이터 삭제·손상이나 더 큰 장애가 발생했을 때 정상 데이터를 이용해 시스템을 복구하는 기술이다.
따라서 이중화가 백업을 대체할 수 없고, 백업 역시 이중화를 대체할 수 없다. 기업에서는 먼저 시스템별 RTO와 RPO를 정의하고, 일반적인 구성 요소 장애는 이중화로 대응하면서 데이터 손상과 재해 상황에는 백업과 복구 체계를 적용하는 방식으로 여러 계층의 장애 대응 구조를 설계해야 한다.
결국 중요한 것은 서버의 개수나 백업 파일의 개수가 아니다. 실제 장애가 발생했을 때 서비스를 얼마나 빨리 이어갈 수 있고, 필요한 데이터를 어느 시점까지 복구할 수 있는지를 검증하는 것이 장애 대응 체계의 핵심이다.
참고자료 / 출처
- NIST — SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems
- AWS — Well-Architected Framework: Back up data
- Microsoft — Architecture strategies for self-healing and self-preservation
- Google Cloud — Architecting disaster recovery for cloud infrastructure outages
- Microsoft — Using availability zones and regions