

티스토리 뷰
기업의 주요 정보시스템은 서버 한 대의 장애만으로 전체 업무가 중단되지 않도록 설계하는 것이 중요하다. ERP, 그룹웨어, 홈페이지, 데이터베이스와 같이 업무 의존도가 높은 시스템은 몇 분의 장애만 발생해도 사용자 업무와 고객 서비스에 직접적인 영향을 줄 수 있기 때문이다.
이러한 문제에 대응하기 위해 사용하는 대표적인 방법이 서버 이중화와 고가용성, 즉 HA(High Availability) 구성이다.
하지만 서버를 두 대 설치했다고 해서 자동으로 고가용성이 확보되는 것은 아니다. 장애를 감지하는 기능, 서비스를 다른 서버로 전환하는 기능, 데이터 동기화, 네트워크와 스토리지의 이중화까지 함께 설계되어야 실제 장애 상황에서도 서비스를 지속할 수 있다.
서버 이중화와 고가용성을 이해할 때는 단순히 장비 수가 몇 대인지보다 어떤 장애가 발생했을 때 서비스가 어떤 방식으로 계속 제공되는지를 중심으로 살펴볼 필요가 있다.
서버 이중화는 동일한 역할을 수행할 수 있는 자원을 준비하는 구조다
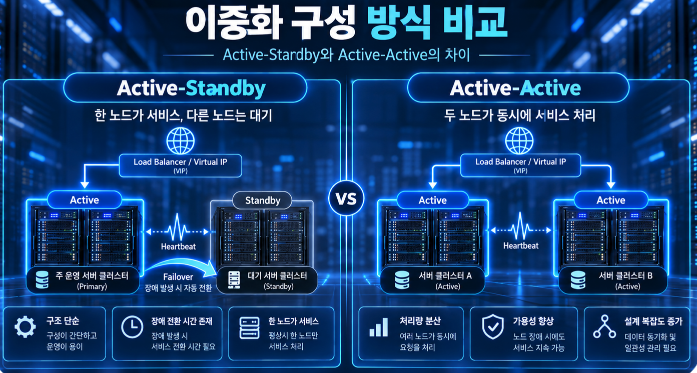
서버 이중화는 하나의 서버에 장애가 발생하더라도 다른 서버가 서비스를 대신할 수 있도록 두 개 이상의 서버 자원을 구성하는 방식이다.
가장 단순한 형태에서는 사용자가 하나의 서버에 접속한다.
사용자 → 서버 A
서버 A 한 대만 운영되는 환경에서는 서버의 하드웨어나 운영체제에 장애가 발생하면 서비스도 함께 중단될 수 있다.
이를 다음과 같은 구조로 변경할 수 있다.
사용자 → 서버 A / 서버 B
서버 A에 문제가 발생했을 때 서버 B가 서비스를 제공할 수 있다면 하나의 서버 장애가 전체 서비스 장애로 이어질 가능성을 낮출 수 있다.
하지만 두 서버 중 어느 서버가 서비스를 제공할지 결정해야 하고, 장애 발생 여부를 판단해야 하며, 필요한 데이터와 네트워크 연결도 유지해야 한다. 이 과정을 자동으로 관리하는 기술이 고가용성 시스템의 핵심이다.
고가용성은 서비스를 가능한 한 지속적으로 제공하는 것이 목적이다
고가용성은 시스템 일부에 장애가 발생하더라도 서비스 중단 시간을 최소화하고 사용 가능한 상태를 유지하도록 설계하는 개념이다.
가용성은 일반적으로 일정 기간 동안 서비스가 정상적으로 사용 가능한 시간의 비율로 표현한다. 가용성이 높다는 것은 단순히 서버가 켜져 있다는 의미가 아니라 사용자가 실제로 필요한 기능을 정상적으로 이용할 수 있어야 한다는 의미다.
고가용성을 구현하려면 일반적으로 다음과 같은 기능이 필요하다.
- 장애가 발생했는지 지속적으로 확인하는 모니터링
- 정상 서버로 서비스를 전환하는 Failover
- 서버 간 데이터 또는 상태 동기화
- 서비스 접속 주소를 유지하는 네트워크 구성
- 특정 장비 하나에 장애가 집중되지 않도록 하는 이중화
- 장애 복구 후 원래 환경으로 돌아가기 위한 운영 절차
고가용성의 목적은 장애 자체를 완전히 없애는 것이 아니다. 중요한 것은 장애가 발생했을 때 서비스에 미치는 영향을 얼마나 줄일 수 있는가이다.
Active-Standby는 대표적인 서버 이중화 방식이다
서버 이중화 구조에서 가장 이해하기 쉬운 형태는 Active-Standby 방식이다.
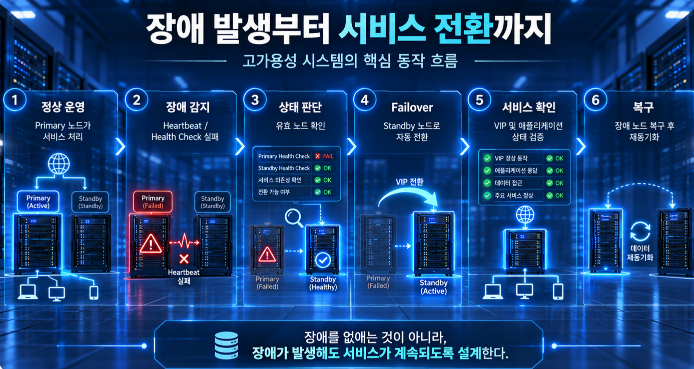
평상시에는 Active 서버가 서비스를 제공하고 Standby 서버는 장애에 대비해 대기한다.
정상 상태
사용자 → Active 서버
Standby 서버 → 대기
Active 서버에서 장애가 발생하면 Standby 서버가 역할을 넘겨받는다.
Active 서버 장애 → Standby 서버 활성화 → 서비스 재개
이러한 서비스 전환 과정을 Failover라고 한다.
Active-Standby 방식은 구조가 비교적 명확하고 장애 발생 시 어느 서버가 서비스를 담당할지 판단하기 쉽다는 장점이 있다.
반면 정상 상태에서는 Standby 서버의 자원을 충분히 활용하지 못할 수 있다. Standby 서버도 항상 실행되어 즉시 전환할 수 있는 Hot Standby 방식이 있는 반면 일부 서비스만 준비된 Warm Standby나 장애 발생 후 시스템을 기동하는 Cold Standby 구조도 사용할 수 있다.
Active-Active는 여러 서버가 동시에 서비스를 처리한다
Active-Active 방식에서는 두 개 이상의 서버가 모두 정상적으로 서비스를 제공한다.
사용자 → 로드밸런서 → 서버 A / 서버 B
로드밸런서는 들어오는 요청을 여러 서버로 분산한다. 정상 상태에서는 두 서버가 모두 업무를 처리하고, 서버 A에서 장애가 발생하면 서버 B가 남은 요청을 처리할 수 있다.
Active-Active 방식의 장점은 평상시에도 여러 서버의 자원을 활용할 수 있다는 것이다. 사용자 요청이 많은 서비스에서는 부하 분산과 고가용성을 동시에 구현할 수 있다.
다만 두 서버가 동시에 같은 데이터를 처리하는 시스템이라면 세션, 데이터 동기화, 동시 쓰기, 애플리케이션 설계 등을 함께 고려해야 한다.
따라서 Active-Active가 항상 Active-Standby보다 우수한 구조라고 볼 수는 없다. 애플리케이션 특성과 업무 요구사항에 적합한 방식을 선택해야 한다.
Heartbeat는 서버 상태를 확인하는 역할을 한다
고가용성 시스템에서는 다른 서버가 정상적으로 동작하고 있는지 확인할 수 있어야 한다.
이를 위해 많이 사용되는 방식 중 하나가 Heartbeat다. 클러스터를 구성한 서버들은 일정한 간격으로 서로의 상태를 확인한다.
서버 B가 일정 시간 동안 서버 A의 응답을 받지 못하면 서버 A에 장애가 발생한 것으로 판단할 수 있다. 이후 클러스터 관리 시스템은 미리 정의된 정책에 따라 Failover를 수행한다.
- 서버 간 상태 확인
- 응답 이상 감지
- 장애 여부 판단
- 서비스 전환 조건 확인
- 정상 서버로 서비스 이동
- 사용자 요청 재개
단순히 Heartbeat가 끊겼다는 이유만으로 무조건 다른 서버를 활성화하면 안 된다. 서버 자체에는 문제가 없지만 두 서버 사이의 네트워크만 단절되는 상황도 발생할 수 있기 때문이다.
Split-Brain과 Quorum도 고려해야 한다
두 서버 사이의 통신이 끊겼을 때 양쪽 서버가 모두 자신이 정상 서버라고 판단하는 상황이 발생할 수 있다. 이를 Split-Brain이라고 한다.
특히 두 서버가 동일한 데이터를 동시에 수정할 수 있는 환경에서는 데이터 불일치나 손상으로 이어질 수 있다.
이를 방지하기 위해 클러스터에서는 Quorum과 같은 의사결정 구조를 사용한다.
Quorum은 클러스터가 정상적으로 서비스를 계속 운영할 수 있는지를 노드의 투표나 별도의 Witness 등을 이용해 결정하는 방식이다.
고가용성 환경에서는 단순히 서버가 살아 있는지를 확인하는 것뿐만 아니라 장애 상황에서도 하나의 올바른 서비스 상태를 유지하는 것이 중요하다.
서버만 이중화하면 전체 시스템의 고가용성이 확보되는 것은 아니다
고가용성을 설계할 때 자주 발생하는 실수는 서버만 두 대로 구성하고 전체 시스템이 이중화되었다고 생각하는 것이다.
서버 두 대가 하나의 스위치에만 연결되어 있다면 해당 스위치가 장애를 일으켰을 때 두 서버 모두 사용할 수 없게 된다.
스토리지도 마찬가지다. 두 서버가 동일한 단일 스토리지에 의존한다면 스토리지 장애가 전체 서비스 장애로 이어질 수 있다.
이처럼 하나의 구성 요소에 장애가 발생했을 때 전체 서비스가 중단되는 지점을 SPOF(Single Point of Failure), 단일 장애 지점이라고 한다.
실질적인 고가용성 환경을 만들기 위해서는 서버뿐 아니라 전체 서비스 경로에서 SPOF를 찾아야 한다.
전체 서비스 경로에서 이중화를 살펴봐야 한다
기업 시스템의 서비스 흐름은 다음과 같이 구성될 수 있다.
사용자 → 인터넷 회선 → 방화벽 → 로드밸런서 → 웹 서버 → 애플리케이션 서버 → 데이터베이스 → 스토리지
웹 서버만 두 대로 구성했다고 해서 전체 서비스가 고가용성 환경이 되는 것은 아니다.
| 영역 | 주요 이중화 대상 |
|---|---|
| 서버 | 물리 서버, 가상 서버, 애플리케이션 |
| 네트워크 | 스위치, 라우터, 네트워크 경로 |
| 보안 | 방화벽, VPN, 보안 게이트웨이 |
| 회선 | 인터넷 회선, 전용회선 |
| 스토리지 | 컨트롤러, 디스크, 스토리지 경로 |
| 데이터베이스 | DB 서버, 복제 구성 |
| 전원 | UPS, 전원 공급 장치 |
| 서비스 | 로드밸런서, DNS, 인증 시스템 |
고가용성은 특정 서버의 기능이 아니라 전체 서비스 아키텍처의 특성으로 이해해야 한다.
서버 이중화와 백업은 목적이 다르다
서버를 이중화하면 백업이 필요 없다고 생각할 수도 있지만 두 기술의 목적은 다르다.
서버 이중화는 서비스 지속을 위한 기술이고, 백업은 손실된 데이터를 복구하기 위한 기술이다.
서버 A와 서버 B가 실시간으로 데이터를 동기화하더라도 사용자의 실수로 중요한 데이터가 삭제되고 해당 내용이 서버 B에도 동기화된다면 이중화만으로 삭제된 데이터를 복원하기 어렵다.
따라서 중요한 시스템에서는 다음 영역을 별도로 설계한다.
- 고가용성: 서비스 지속
- 백업: 데이터 복구
- 재해복구: 데이터센터 또는 지역 단위 장애 대응
고가용성과 재해복구도 범위가 다르다
HA와 DR(Disaster Recovery)은 모두 장애에 대비하지만 보호하려는 장애의 범위가 다를 수 있다.
같은 전산실에 서버 두 대를 설치하면 서버 한 대의 장애에는 대응할 수 있다. 하지만 건물 전체의 정전이나 화재, 데이터센터 장애가 발생하면 같은 장소에 있는 두 서버가 동시에 영향을 받을 수 있다.
- 서버 장애 → 서버 또는 클러스터 이중화
- 랙·네트워크 장비 장애 → 인프라 경로 이중화
- 데이터센터 장애 → 원격지 또는 다른 가용 영역 활용
- 지역 단위 재해 → 별도 지역의 DR 환경
서버 이중화는 고가용성을 구성하는 중요한 요소지만 모든 재해 상황을 해결하는 기술은 아니다.
RTO와 RPO를 먼저 결정하면 필요한 구조가 달라진다
모든 시스템을 최고 수준으로 이중화하면 비용과 운영 복잡성이 크게 증가한다. 따라서 실제 기업에서는 업무 요구사항을 기준으로 필요한 가용성 수준을 결정해야 한다.
RTO
Recovery Time Objective의 약자로 장애가 발생한 후 서비스를 복구하는 데 허용할 수 있는 목표 시간을 의미한다.
RPO
Recovery Point Objective의 약자로 장애 발생 시 어느 시점까지의 데이터 손실을 허용할 수 있는지를 나타낸다.
사내 참고용 시스템과 실시간 결제 시스템을 동일한 수준으로 구성할 필요는 없다. 먼저 업무 중요도와 허용 가능한 장애 시간을 결정한 뒤 그에 맞는 이중화 구조를 선택하는 것이 중요하다.
Failover가 실제로 동작하는지 확인해야 한다
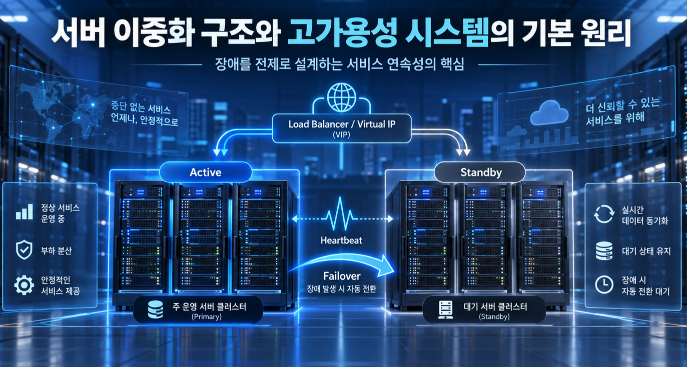
이중화 환경을 구축했다고 해서 장애 대응이 끝나는 것은 아니다. 실제 장애가 발생했을 때 Failover가 정상적으로 이루어지는지 정기적으로 검증해야 한다.
- Active 서버 강제 종료
- 애플리케이션 프로세스 중단
- 네트워크 연결 장애
- 스토리지 연결 장애
- 로드밸런서 대상 서버 장애
- 서버 간 Heartbeat 단절
- Failover 이후 서비스 정상 여부
- 복구된 서버로의 Failback
장애 전환이 정상적으로 이루어졌더라도 애플리케이션 로그인이나 데이터 처리 기능이 정상적으로 동작하지 않는 경우도 있다. 따라서 서버 상태뿐만 아니라 사용자가 실제로 서비스를 사용할 수 있는지까지 확인해야 한다.
서버 두 대보다 중요한 것은 전체 구조다
서버 이중화의 목적은 장비를 두 대 보유하는 데 있지 않다.
장애가 발생했을 때 이를 감지하고, 정상 자원이 서비스를 이어받고, 사용자가 가능한 한 짧은 시간 안에 서비스를 다시 이용할 수 있도록 하는 것이 핵심이다.
Active-Standby와 Active-Active는 이러한 목적을 구현하는 대표적인 방식이며 Heartbeat, Failover, Quorum, 데이터 동기화와 같은 기술이 함께 사용된다.
또한 서버만 이중화해 놓고 네트워크, 스토리지, 전원과 같은 다른 구성 요소를 단일 구조로 운영한다면 완전한 고가용성을 기대하기 어렵다.
장애 가능성 확인 → 단일 장애 지점 식별 → 이중화 → 장애 감지 → Failover → 서비스 확인 → 복구
이 원리를 이해하면 이후 Active-Active와 Active-Standby 구성, 로드밸런싱, 클러스터, 데이터베이스 이중화, 스토리지 이중화, 재해복구 시스템까지 자연스럽게 확장해 이해할 수 있다.
참고자료
- Microsoft Learn - Failover Clustering in Windows Server and Azure Local
- Microsoft Learn - Understand cluster and pool quorum
- AWS Well-Architected Framework - Design your workload to withstand component failures
- AWS Well-Architected Framework - Availability
- IBM Documentation - High availability through clustering
- IBM Documentation - High availability through failover