
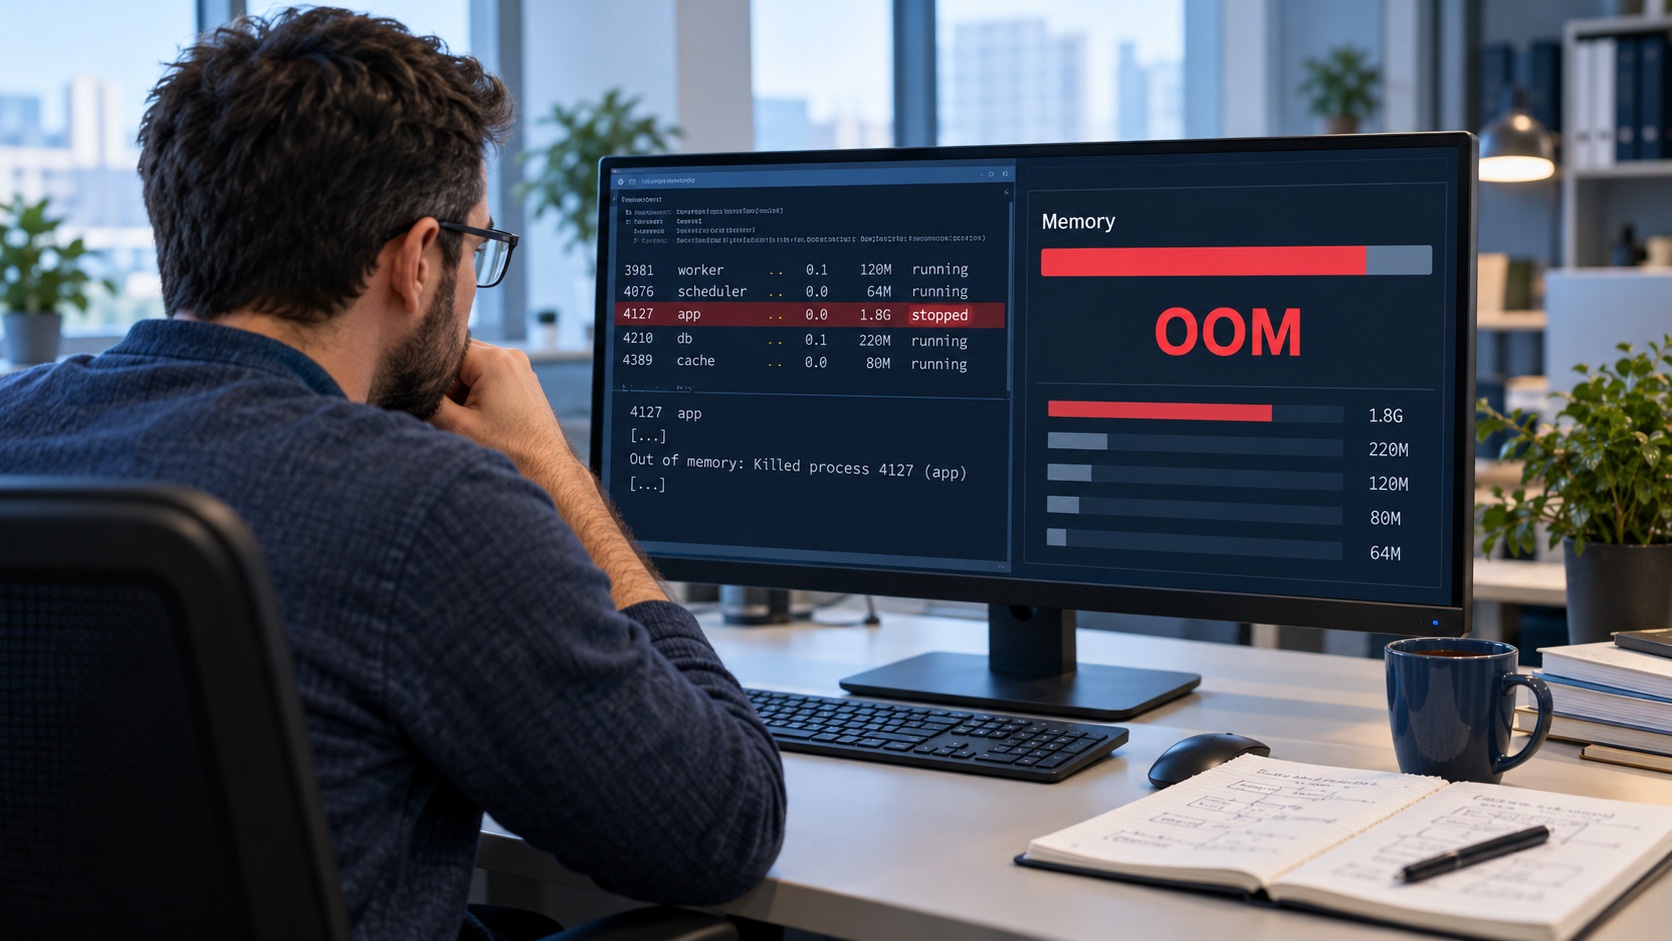
서버에서 애플리케이션이 갑자기 사라졌는데 재시작 후에는 정상으로 보일 때가 있다. 이때 현재 메모리 사용량만 보면 종료 당시의 상황을 놓칠 수 있다. 커널의 OOM(Out of Memory) 기록을 확인하면 종료 시각과 대상 프로세스를 찾고, 서버 전체의 메모리 압박인지 특정 서비스의 제한인지 조사 범위를 좁힐 수 있다.
OOM 기록이 알려주는 것과 알려주지 않는 것
커널은 메모리 확보에 실패한 상황에서 OOM killer를 호출해 프로세스를 종료할 수 있다. 다만 메모리 할당 실패가 모두 OOM killer의 실행으로 이어지는 것은 아니다. 커널 로그에 남은 종료 대상은 그 시점에 선택된 프로세스이지, 메모리 부족을 처음 일으킨 유일한 원인이라는 뜻은 아니다.
서버 전체에 여유가 없어 발생하는 경우와 cgroup에 설정된 한도에 도달한 경우를 구분해야 한다. 특히 컨테이너나 systemd 서비스는 호스트에 여유가 있어도 자신 또는 상위 cgroup의 제한에 부딪힐 수 있다. 먼저 종료 시각, 프로세스 식별자(PID), 이름, OOM 범위와 주변 로그를 함께 모은다.
1. 장애 시각의 커널 로그 찾기
systemd 저널을 사용하는 서버에서 현재 부팅의 커널 기록을 조회한다. 아래 명령은 읽기 전용이며 로그 열람 권한에 따라 sudo가 필요할 수 있다. grep 결과는 단서이므로 해당 시각의 전체 커널 로그도 함께 살펴본다.
sudo journalctl -k -b --no-pager | grep -iE 'out of memory|oom-kill|killed process'
sudo journalctl -k -b --since '2026-11-01 10:00:00' --until '2026-11-01 10:10:00' --no-pager
시간은 실제 장애 시각과 서버 시간대에 맞게 바꾼다. 재부팅 전에 발생한 장애라면 journalctl --list-boots로 보존된 부팅 목록을 보고, 직전 부팅은 sudo journalctl -k -b -1 --no-pager로 조회한다. 이전 저널이 휘발성 저장소에만 있었거나 순환 삭제되었다면 보이지 않을 수 있다. 기록이 없다는 사실만으로 OOM이 없었다고 결론 내리지 않는다.
2. 종료 대상과 발생 범위 읽기
다음은 형식을 이해하기 위한 가상의 예시이며, 배포판과 커널 버전에 따라 문구와 필드는 달라질 수 있다.
Nov 01 10:03:12 host kernel: Memory cgroup out of memory: Killed process 2345 (java) total-vm:3000000kB, anon-rss:1800000kB, file-rss:12000kB, shmem-rss:0kB시각은 서비스 장애 기록과 대조하고, 2345와 java는 종료 대상의 PID와 이름으로 읽는다. total-vm은 가상 메모리 크기이고 anon-rss·file-rss 등은 서로 다른 상주 메모리 항목이다. total-vm을 실제 물리 메모리 점유량으로 해석하면 안 된다. 위 문구는 cgroup OOM 단서이지만, 실제 로그의 앞뒤에 있는 cgroup 경로와 제한 정보를 확인해야 한다.
PID는 종료 후 재사용될 수 있으므로 현재 같은 PID가 보인다고 동일 프로세스라고 가정하지 않는다. 장애 당시의 서비스 로그, 컨테이너 식별자, 배포 시각과 함께 연결한다. 종료 대상이 큰 메모리를 사용했더라도 동시 작업 증가나 다른 프로세스, 잘못 설정된 제한이 압박에 기여했을 수 있다.
3. 서비스와 cgroup의 메모리 제한 대조
현재 실행 중인 systemd 서비스라면 먼저 실제 서비스 이름을 지정해 상태와 cgroup 경로, 제한을 확인한다. 재시작이나 재생성 후의 값은 장애 당시 값과 다를 수 있다.
systemctl status example.service
systemctl show example.service -p ControlGroup -p MemoryCurrent -p MemoryMax
stat -fc %T /sys/fs/cgroup
마지막 명령이 cgroup2fs를 반환하는 cgroup v2 환경에서는 ControlGroup에 표시된 경로를 /sys/fs/cgroup 뒤에 붙여 확인할 수 있다. 예를 들어 경로가 /system.slice/example.service인 경우 다음과 같다. 이 파일들이 없는 환경이나 cgroup v1에서는 다른 인터페이스를 사용한다.
sudo cat /sys/fs/cgroup/system.slice/example.service/memory.current
sudo cat /sys/fs/cgroup/system.slice/example.service/memory.max
sudo cat /sys/fs/cgroup/system.slice/example.service/memory.events
sudo cat /sys/fs/cgroup/system.slice/example.service/memory.events.local
memory.current는 현재 사용량, memory.max는 해당 cgroup에 설정된 상한이며 max는 그 위치에 수치 상한이 없다는 뜻이다. 상위 cgroup의 제한은 별도로 확인해야 한다. memory.events의 max·oom·oom_kill은 누적 이벤트 수이며 기본적으로 하위 cgroup을 포함한다. memory.events.local은 해당 수준의 이벤트를 보여준다. oom_kill 증가는 해당 cgroup의 프로세스가 어떤 유형의 OOM killer에 의해 종료됐다는 뜻이므로, 이것 하나만으로 해당 cgroup의 자체 한도 초과를 확정하지 않는다.
이 수치는 현재 존재하는 cgroup의 관측값이다. 재시작이나 컨테이너 재생성으로 cgroup이 바뀌었다면 과거 수치를 복원하지 못할 수 있다. 컨테이너라면 당시의 런타임·오케스트레이터 이벤트와 제한 설정, 상위 cgroup을 함께 확인한다.
4. 관측 결과에 따른 다음 확인
- 커널 로그에 전체 시스템 OOM 정황이 있고 여러 작업이 동시에 증가했다면: 장애 직전 호스트 메모리·스왑 추이와 배치 실행 시간을 비교한다. 현재 free 출력은 과거 사용량의 증거가 아니다.
- cgroup OOM 정황과 제한 도달 기록이 있다면: 당시 서비스와 상위 그룹의 제한, 작업량, 메모리 추이를 확인한다. 한도를 올리기 전 호스트의 다른 작업에 미칠 영향도 살펴본다.
- 종료 기록은 있으나 범위가 불명확하다면: 검색 결과 한 줄 대신 전후 커널 기록, 서비스·컨테이너 이벤트와 모니터링 자료를 모아 판단을 보류한다.
- OOM 기록을 찾지 못했다면: 저널 보존 여부와 권한을 확인하고 서비스 자체 오류, 수동 종료, 사용자 공간 OOM 관리자의 기록도 별도로 조사한다.
실무자 관점: 재시작보다 증거 보존이 먼저
서비스 복구가 급하더라도 가능한 범위에서 종료 시각과 로그, 서비스 설정, 모니터링 그래프를 먼저 확보하면 재발 원인을 좁히기 쉽다. 특히 재배포 후에는 이전 컨테이너와 cgroup이 사라져 현재 설정만으로 당시 상황을 재현하기 어렵다. 로그와 지표의 보존 기간을 장애 조사에 필요한 기간과 맞추고, 민감한 경로와 정보는 공유 전 가린다.
메모리를 늘리는 조치는 일시적인 여유를 줄 수 있지만, 제한 설정 오류나 요청 급증, 메모리 증가 원인을 자동으로 설명하지는 않는다. 반대로 서비스 제한만 올리면 호스트 전체에 가해지는 부담이 커질 수 있다. 장애 당시의 범위와 사용 추이를 확인한 다음 한도 조정, 동시성 제한, 애플리케이션 분석 중 선택한다.
결론
OOM 분석의 출발점은 종료된 프로세스 이름 하나가 아니라 발생 시각과 제한 범위를 묶어 보는 것이다. 커널 로그로 대상을 찾고 서비스·cgroup 설정과 당시 지표를 대조하면, 호스트 증설이 필요한지 특정 작업의 제한과 사용 패턴을 손봐야 하는지 더 근거 있게 결정할 수 있다.