
기업의 보안 환경에서는 방화벽, IPS, WAF, 서버, 운영체제, 웹 애플리케이션, 인증 시스템, 클라우드 서비스 등 수많은 시스템이 각각 다른 형식으로 로그를 생성한다. 같은 IP 주소를 의미하더라도 어떤 장비는 src, 다른 제품은 source_ip, 또 다른 시스템은 client_ip와 같이 서로 다른 필드명을 사용할 수 있다.

이처럼 형식과 의미가 제각각인 로그를 그대로 수집하기만 해서는 통합 검색이나 이벤트 상관분석이 어렵다. 그래서 SIEM(Security Information and Event Management)과 중앙 로그 관리 환경에서는 서로 다른 로그를 공통된 형태로 변환하는 로그 정규화(Log Normalization) 과정이 중요하다.
NIST는 로그 정규화를 각 로그 데이터 필드를 일정한 데이터 표현 방식으로 변환하고 일관된 기준으로 분류하는 과정으로 설명한다. 대표적인 예가 서로 다른 날짜·시간 형식과 타임존을 하나의 기준으로 맞추는 것이다. 여러 형식의 로그를 함께 분석할 때 정규화를 적용하면 분석과 보고가 쉬워지는 반면, 복잡한 로그를 처리할수록 자원 소모도 커질 수 있다.
- 로그 정규화가 필요한 이유
- 파싱과 정규화의 차이
- 서로 다른 로그가 공통 필드로 변환되는 과정
- 정규화된 로그를 이용한 보안 분석
- 로그 정규화에서 중요한 필드
- 정규화 설계 시 주의해야 할 문제
- 실무자 관점에서 본 로그 정규화
- 결론
1. 로그 정규화가 필요한 이유
보안 장비나 시스템마다 로그 형식은 다르다. 예를 들어 외부 IP 주소 203.0.113.10이 내부 서버에 접근한 동일한 상황이라도 제품에 따라 서로 다른 필드 이름으로 기록될 수 있다.
| 로그 종류 | 원본 필드 예시 | 의미 |
|---|---|---|
| 방화벽 | src=203.0.113.10 |
통신 시작지 IP |
| 웹 서버 | client_ip=203.0.113.10 |
HTTP 요청 클라이언트 IP |
| 보안 솔루션 | sourceAddress=203.0.113.10 |
탐지 이벤트의 출발지 IP |
| 정규화 결과 | source.ip=203.0.113.10 |
공통 기준의 출발지 IP |
사람이 로그 한두 건을 직접 보는 경우에는 필드 이름이 달라도 의미를 파악할 수 있다. 하지만 수천만 건의 이벤트를 자동 분석하는 SIEM에서는 상황이 다르다.
탐지 규칙이 source.ip라는 공통 필드를 기준으로 작성되어 있다면 새로운 보안 장비가 추가되더라도 해당 장비의 원본 필드를 source.ip에 정확히 매핑하면 기존 분석 로직을 계속 활용할 수 있다. 공통 스키마를 사용하는 목적도 서로 다른 데이터 소스를 일관된 방식으로 검색·시각화·상관분석하기 위한 것이다. Elastic Common Schema(ECS) 역시 로그와 메트릭 등 이벤트 데이터를 공통 필드로 표현함으로써 서로 다른 데이터의 분석과 상관관계를 쉽게 만드는 것을 목표로 한다.
2. 파싱과 정규화의 차이
로그 분석에서 파싱(Parsing)과 정규화(Normalization)는 비슷하게 사용되지만 역할은 다르다.
파싱
파싱은 하나의 원본 로그 문자열에서 필요한 값을 분리하는 과정이다. 예를 들어 ALLOW 203.0.113.10 10.0.0.20 TCP 443이라는 로그가 있다면 Action, Source, Destination, Protocol, Destination Port 등의 값을 각각 추출할 수 있다.
즉, 파싱은 원본 문자열의 구조를 해석해 필드를 추출하는 작업이다.
정규화
정규화는 추출된 필드를 조직이나 SIEM에서 사용하는 공통 필드 체계에 맞게 변환하는 단계다.
| 파싱된 필드 | 정규화된 필드 |
|---|---|
src |
source.ip |
dst |
destination.ip |
dpt |
destination.port |
user_name |
user.name |
result=allowed |
event.outcome=success 또는 정책에 따른 공통 상태값 |
따라서 파싱은 값을 꺼내는 작업이고, 정규화는 그 값의 의미와 표현 방식을 통일하는 작업이라고 볼 수 있다. 이 두 과정을 구분하는 것이 중요한 이유는 파싱이 정상이어도 정규화가 잘못될 수 있기 때문이다. 예를 들어 실제 목적지 IP를 source.ip에 매핑하면 로그 수집 자체는 정상으로 보이지만 이후 상관분석 결과는 잘못될 수 있다.
3. 서로 다른 로그가 공통 필드로 변환되는 과정
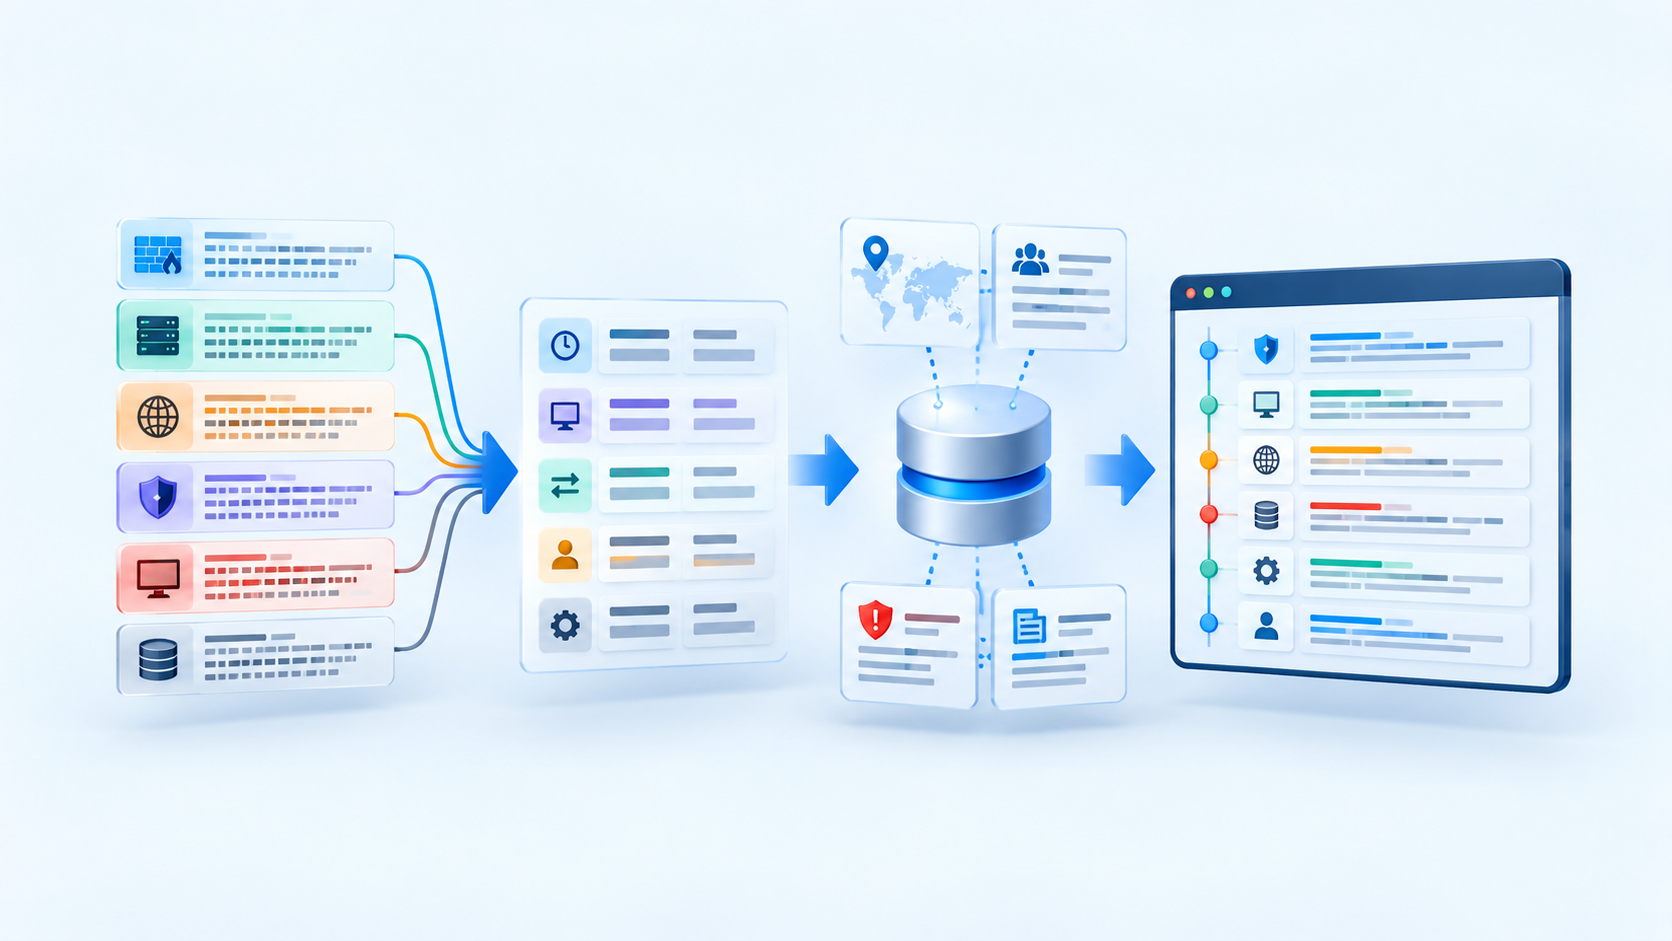
일반적인 중앙 로그 분석 흐름은 로그 생성 → 수집 → 파싱 → 정규화 → 보강 → 상관분석·탐지 → 저장·검색의 순서로 구성할 수 있다.
3.1 로그 수집
먼저 방화벽, 서버, 애플리케이션, 인증 시스템 등에서 로그를 수집한다. 수집 방식에는 Syslog, 에이전트, API, 파일 수집, 이벤트 스트리밍 등 다양한 방법이 사용될 수 있다. Syslog 자체도 표준화된 메시지 구조를 정의하고 있으며 RFC 5424에서는 헤더와 구조화 데이터 등을 포함한 Syslog 메시지 형식을 규정한다.
3.2 파싱
수집한 원본 메시지에서 시간, IP 주소, 사용자, 이벤트 유형, 결과, 포트 등의 값을 추출한다. 이 단계에서는 정규식, JSON 필드, Key-Value 구조, XML 또는 제품별 전용 파서가 사용될 수 있다.
3.3 정규화
추출된 값을 공통 필드에 매핑한다. 예를 들어 src_ip, client_ip, remote_addr, sourceAddress가 모두 동일한 의미라면 공통 필드인 source.ip 등으로 변환할 수 있다.
3.4 보강
정규화 이후에는 필요에 따라 로그에 추가 정보를 결합한다. IP 주소와 자산 정보 연결, 계정과 조직 정보 연결, 내부·외부 네트워크 구분, 중요 서버 여부 표시, 위협 인텔리전스 정보 연결 등이 대표적인 예다.
정규화가 형식을 맞추는 과정이라면 보강은 분석에 필요한 맥락을 추가하는 과정이라는 차이가 있다.
3.5 상관분석과 탐지
공통 필드가 확보되면 서로 다른 시스템의 이벤트를 하나의 조건으로 연결하기 쉬워진다. 예를 들어 외부 IP에서 웹 서비스 로그인 실패가 반복되고, 동일한 IP가 WAF에서 비정상 요청으로 탐지되며, 같은 시간대에 계정 잠금 이벤트가 발생한다면 SIEM은 source.ip, user.name, @timestamp 등의 공통 값을 기준으로 이벤트를 연결할 수 있다.
이처럼 정규화는 이벤트 하나의 내용을 예쁘게 만드는 작업보다 서로 다른 이벤트를 연결하기 위한 기반 작업에 가깝다.
4. 정규화된 로그를 이용한 보안 분석
정규화의 가장 큰 효과는 탐지 규칙과 검색 조건을 데이터 소스별로 따로 작성하지 않아도 된다는 점이다. 방화벽 A에서는 src, 방화벽 B에서는 sourceAddress, 클라우드 보안 서비스에서는 client_ip를 사용하더라도 모든 값을 source.ip로 변환한다면 공통 분석 논리를 적용할 수 있다.
예를 들어 동일한 source.ip에서 여러 계정을 대상으로 반복적인 인증 실패가 발생하는가라는 탐지 조건을 공통 필드 기준으로 작성할 수 있다. 이 방식은 장비가 추가될 때마다 탐지 규칙 전체를 수정하는 대신 새로운 로그 소스를 기존 공통 스키마에 정확하게 매핑하는 방식으로 확장할 수 있다는 장점이 있다.
OCSF(Open Cybersecurity Schema Framework)도 서로 다른 보안 데이터 스키마를 공통 언어로 매핑해 데이터 수집과 정규화를 단순화하고, 탐지와 조사 과정에서 일관된 데이터 구조를 사용할 수 있도록 하는 것을 목표로 한다.
5. 로그 정규화에서 중요한 필드
모든 필드를 무조건 동일하게 만드는 것보다 분석에 실제로 사용되는 핵심 필드를 우선적으로 관리하는 것이 효과적이다.
5.1 시간
로그 분석에서 가장 중요한 항목 중 하나가 시간이다. 이벤트가 실제로 발생한 시간, 로그가 수집된 시간, SIEM에 저장된 시간, 타임존, 시스템 간 시간 동기화 상태를 구분해서 확인해야 한다.
NIST 역시 여러 타임존을 사용하는 환경에서는 시간을 하나의 기준으로 변환해야 하며 시스템의 시계가 맞지 않으면 이벤트 순서 분석에 문제가 생길 수 있다고 설명한다. ECS도 원본 이벤트가 발생한 시간을 @timestamp, 파이프라인이 이벤트를 읽거나 중앙 저장소에 도착한 시간을 별도 필드로 구분할 수 있도록 정의한다.
5.2 출발지와 목적지
네트워크 로그에서는 source와 destination 의미를 정확하게 구분해야 한다. 단순히 로그에서 앞에 있는 IP를 출발지로 처리하면 NAT, 프록시, 로드밸런서, 리버스 프록시 환경에서 실제 통신 주체를 잘못 해석할 수 있다.
5.3 사용자와 계정
운영체제 계정, 애플리케이션 사용자, 이메일 주소, 디렉터리 계정 등이 서로 다르게 표현될 수 있다. 사용자 관련 필드를 통합할 때는 동일한 문자열이라는 이유만으로 같은 사용자를 의미한다고 단정하지 않아야 한다.
5.4 이벤트 결과
제품마다 성공·실패를 allow / deny, accepted / rejected, success / failure, 0 / 1 등 서로 다른 방식으로 표현할 수 있다. 이를 공통 상태값으로 정규화하면 여러 로그를 동일한 기준으로 검색하기 쉬워진다.
5.5 이벤트 심각도
심각도는 특히 주의해야 한다. 한 제품의 Severity 5와 다른 제품의 Severity 5가 같은 의미라는 보장은 없다. 따라서 가능하면 제품이 기록한 원본 심각도와 조직 또는 SIEM에서 다시 계산한 정규화 심각도를 분리해서 관리하는 편이 안전하다.
ECS에서도 이벤트 소스가 제공한 심각도와 여러 시스템의 값을 비교하기 위한 정규화된 위험 점수를 별도 개념으로 다룬다.
6. 정규화 설계 시 주의해야 할 문제
원본 로그를 버리지 않는다
정규화 과정에서 필요한 필드만 남기고 원본 메시지를 삭제하면 사고 분석이나 파서 오류 확인이 어려워질 수 있다. 정규화 필드는 빠른 검색과 상관분석에 사용하고, 원본 로그 또는 원본 메시지도 필요에 따라 다시 확인할 수 있도록 유지하는 방식이 좋다. ECS 역시 원본 이벤트를 보존하기 위한 event.original 필드를 정의하고 있다.
모든 필드를 억지로 공통화하지 않는다
제품 고유 정보까지 무리하게 공통 필드로 변환하면 오히려 의미가 손실될 수 있다. 공통 분석에 필요한 필드는 표준화하고, 제품 고유 필드는 별도로 유지하는 방식이 현실적이다.
파서 변경을 관리한다
장비 펌웨어나 애플리케이션 버전이 변경되면 로그 포맷도 바뀔 수 있다. 수집량은 정상인데 특정 필드가 갑자기 비어 있거나 unknown 이벤트가 증가한다면 파서가 새로운 포맷을 처리하지 못하고 있을 가능성을 확인해야 한다.
정규화 성공률을 점검한다
SIEM에서 로그가 들어오는 것만 확인해서는 충분하지 않다. 미파싱 이벤트 비율, 필수 필드 누락률, 시간 필드 오류, 잘못된 source/destination 매핑, 이벤트 유형의 과도한 unknown 분류, 제품 업데이트 이후 필드 구조 변화 등을 함께 확인하는 것이 좋다.
정규화 품질이 떨어지면 탐지 룰이 정상 동작하더라도 실제 공격 이벤트가 조건에 들어오지 않을 수 있다.
7. 실무자 관점에서 본 로그 정규화
SIEM 운영에서 탐지 룰 자체보다 먼저 확인해야 하는 것이 로그 품질이다. 어떤 탐지 룰이 source.ip, destination.ip, user.name, event.action을 사용한다고 하더라도 실제 로그에서 이 필드가 잘못 매핑되어 있다면 탐지 로직이 아무리 정교해도 의미가 없다.
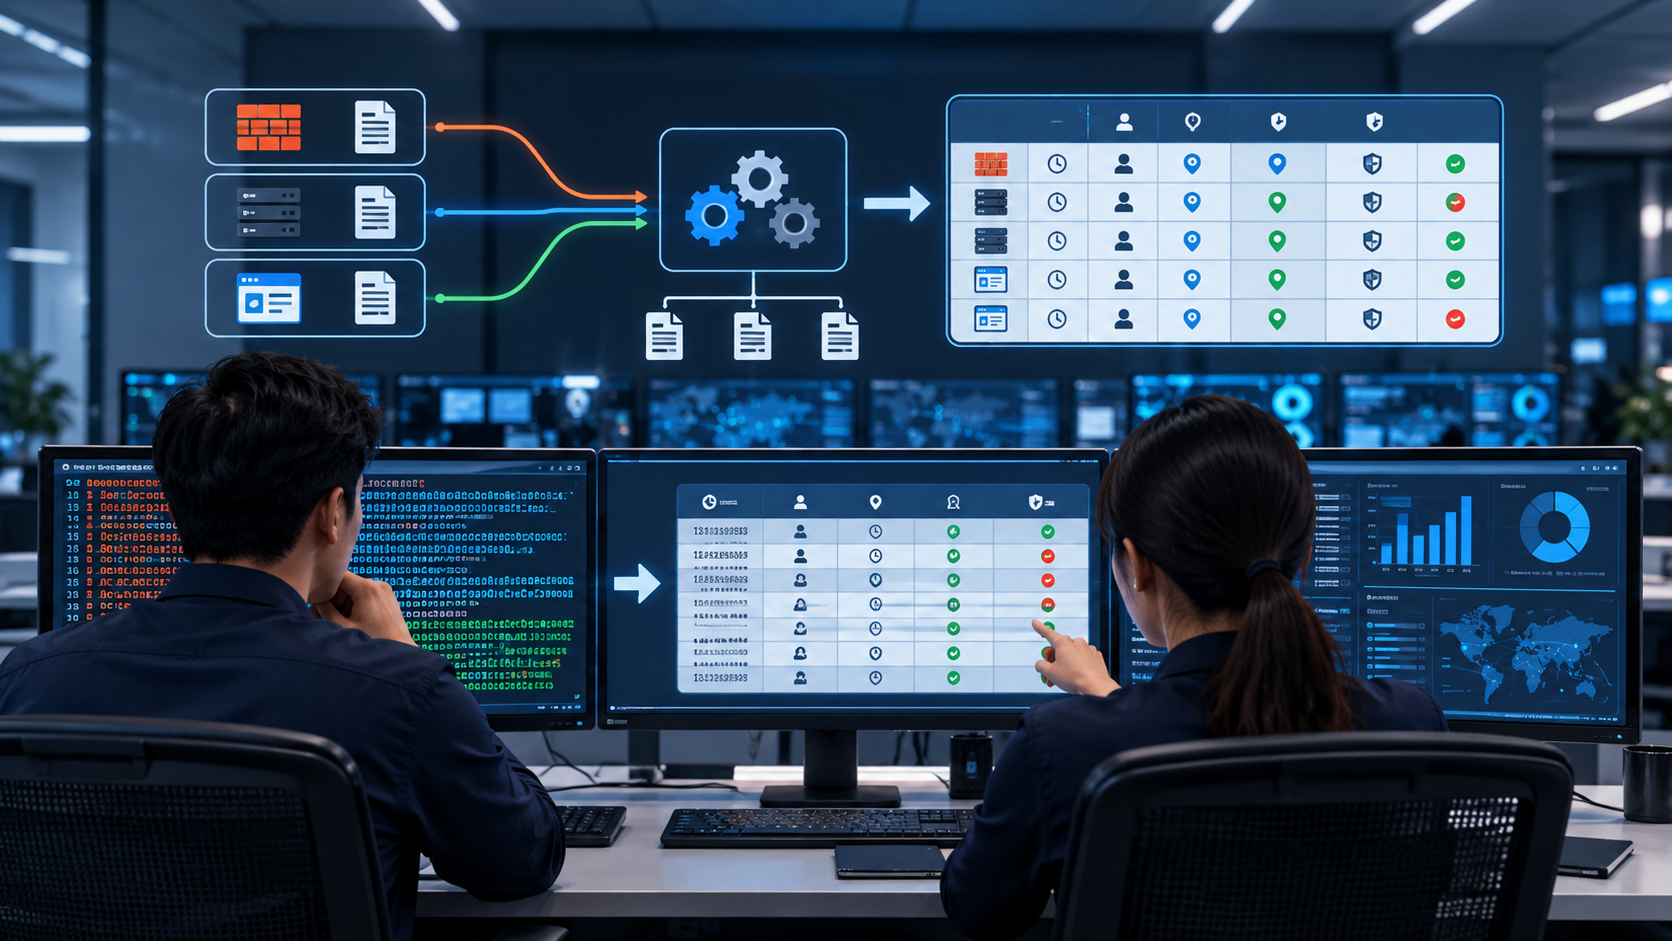
특히 새로운 장비를 SIEM에 연동할 때는 단순히 “로그가 들어온다”는 사실만으로 연동 완료를 판단하지 않는 것이 좋다. 대표 이벤트를 직접 발생시켜 원본 로그와 정규화 필드를 비교하고, 주요 필드가 의도한 의미로 매핑되는지 확인해야 한다.
- 원본 로그를 먼저 확인한다.
- 주요 이벤트 유형을 선정한다.
- 파싱 결과를 검증한다.
- 공통 필드 매핑을 확인한다.
- 기존 탐지 규칙에서 정상적으로 검색되는지 확인한다.
- 제품 업데이트 후 같은 테스트를 반복한다.
또한 정규화 범위를 지나치게 넓히면 관리할 매핑 규칙이 빠르게 증가한다. NIST도 정규화가 분석을 쉽게 만드는 대신 복잡한 로그에서는 많은 처리 자원이 필요할 수 있다고 지적한다. 따라서 모든 필드를 정규화하는 것보다 탐지·조사·보고에 실제로 사용하는 핵심 필드를 우선하는 방식이 운영 효율 측면에서 더 현실적이다.
8. 결론
로그 정규화는 서로 다른 시스템의 로그를 단순히 같은 모양으로 바꾸는 작업이 아니다. 핵심 목적은 방화벽, 서버, 애플리케이션, 인증 시스템 등 서로 다른 데이터 소스에서 발생한 이벤트를 공통 기준으로 검색하고 서로 연결해 분석할 수 있도록 만드는 것이다.
효과적인 로그 정규화를 위해서는 파싱과 정규화를 구분하고, 시간·IP·사용자·이벤트 결과·심각도 같은 핵심 필드의 의미를 정확하게 매핑해야 한다. 동시에 원본 로그를 보존하고, 제품 고유 정보까지 무리하게 공통화하지 않으며, 파서와 필드 매핑 상태를 지속적으로 검증해야 한다.
결국 SIEM의 탐지 품질은 탐지 규칙뿐 아니라 그 규칙에 입력되는 데이터 품질에 크게 좌우된다. 정확한 로그 수집 → 올바른 파싱 → 일관된 정규화 → 상관분석이라는 흐름이 제대로 구성되어야 서로 다른 보안 로그를 하나의 관점에서 분석할 수 있다.